【干货】SQL优化方法优化技巧,性能提升10倍
SQL 优化真正拉开差距的地方,不是背规则,而是先看懂执行计划,再减少数据库做的工作量。 下面这套方法适用于 MySQL、PostgreSQL、SQL
Server 等主流数据库,按“诊断 → 改写 → 索引 → 架构”推进。
一、先诊断:不要凭感觉优化
优化前先看三个数据源:
慢查询日志:找出执行时间超过阈值的 SQL。
EXPLAIN / EXPLAIN ANALYZE:看数据库实际怎么执行。
执行计划关键字段:重点关注 type、key、rows、Extra。
MySQL 中优先关注:
type=ALL:全表扫描,通常必须优化。
key=NULL:没有命中索引。
rows 过大:预计扫描行数太多。
Extra 出现 Using filesort、Using temporary:排序和临时表开销较高。
PostgreSQL 或阿里云 PolarDB 场景下,建议直接用 EXPLAIN ANALYZE,对比预估行数和实际行数,判断统计信息是否失真。
二、先改写:让数据库少干活
很多慢查询不是缺索引,而是写法让数据库做了大量无效计算。
避免 SELECT *:只查必要字段,更容易命中覆盖索引,减少回表。
提前过滤:把 WHERE 条件尽量下推到子查询、JOIN 之前。
避免对索引列做函数运算:例如 WHERE DATE(create_time) = '2026-01-01' 容易导致索引失效,可改为范围查询。
谨慎使用 LIKE '%xxx%':前缀模糊查询可能走索引,中间模糊通常不走;复杂文本搜索可考虑全文索引。
深分页要优化:LIMIT 100000, 10 会先扫描大量行再丢弃,可改用游标分页、键集分页或延迟关联。
IN / EXISTS 看数据量:子查询结果集小且有关联索引时,IN 可能更高效;大表关联或需要判断存在性时,EXISTS 通常更稳。
减少不必要的 DISTINCT、ORDER BY、GROUP BY:这些操作可能触发排序、去重和临时表。
批量写入替代逐条写入:减少网络往返和事务开销。
三、再建索引:索引越准越好
索引不是越多越好,每个索引都应该服务明确查询场景。
复合索引遵循高筛选度等值条件在前:例如 WHERE user_id = ? AND status = ? AND create_time > ?,索引可设计为 (user_id, status, create_time)。
覆盖索引收益很大:如果查询字段都能从索引中拿到,就能避免回表。
避免过度索引:索引会提升读性能,但会拖慢写入,并增加存储和维护成本。
定期清理无效索引:通过索引使用统计确认是否真正被查询命中。
警惕隐式类型转换:字符串字段用数字比较、字符集不一致,都可能导致索引失效。
函数索引可解决特定问题:例如需要按日期范围查询,但业务写法常对时间列做函数处理时,可考虑函数索引或改写查询。
四、架构层兜底:索引解决不了时再动结构
当单表数据量、并发量和写入压力持续增长时,仅靠 SQL 改写和索引可能不够。
读写分离:把报表、导出、复杂查询分流到只读库。
缓存热点数据:对高频读、低频写的数据使用 Redis 等缓存。
分区表:按时间、租户、地区等维度拆分大表,降低单分区扫描量。
分库分表:单表长期超过数百万行、单库 QPS 很高时再评估,不能把它当成万能解。
汇总表 / 物化视图:对报表、排行榜、统计看板提前聚合,避免实时重算。
五、一套可复用的优化流程
抓慢查询,按“耗时 × 频率”排序。
用 EXPLAIN / EXPLAIN ANALYZE 定位瓶颈。
先看能否改写 SQL,减少扫描和计算。
再设计最小必要索引,优先覆盖索引和复合索引。
在测试环境验证,避免影响线上执行计划。
上线后继续监控慢查询、CPU、IO、缓冲池命中率和锁等待。
一句话总结:好 SQL 不是写得复杂,而是让数据库少走弯路。先用执行计划定位问题,再通过改写减少工作量,最后用索引和架构手段兜底,性能提升才会稳定、可复现。
-
 【干货】SQL优化方法优化技巧,性能提升10倍
SQL 优化真正拉开差距的地方,不是背规则,而是先看懂执行计划,再减少数据库做的工作量。 下面这套方法适用于 MySQL、PostgreSQL、SQL Server 等主流数据库,按“诊断 → 改写 → 索引 → 架构”推进。 一、先诊断:不要凭感觉优化优化前先看三个数据源:慢查询日志...
-
 Redis集群思维导图详解:从理论到生产环境实践
Redis 集群思维导图详解:从理论到生产环境实践一句话总纲:Redis 集群核心目标是分片扩容 + 高可用,主流三种方案:主从复制、哨兵 Sentinel、Redis Cluster(官方集群);生产优先 Cluster,哨兵适合中小规模读写分离,主从仅适合学习或简单备份。下面按照思维导图结构逐...
-
 【深入浅出】Elasticsearch安全教程,一文讲透核心原理
【深入浅出】Elasticsearch 安全教程,一文讲透核心原理很多人上手 ES 第一步就是裸奔直接对外,这是最大隐患。ES 安全不只是加个账号密码,包含身份认证、授权、传输加密、审计、网络隔离、数据脱敏、集群防篡改整套体系,本文从原理到落地,适合运维、后端、...
-
 HBase面试题常见问题排查手册
HBase 面试题常见问题排查手册面向后端、大数据开发面试,分为:基础概念、读写原理、架构、RowKey 设计、预分区、版本与删除、集群运维、线上故障排查、对比题、高频手写题。每个问题附带【标准答案】+【面试加分点】,适合背诵 + 排查线上问题。 一、基础概...
-
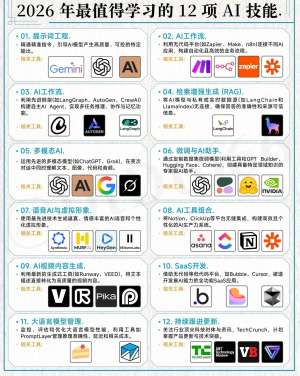 2026年AI数据库学习笔记最新趋势与技术选型
2026年AI数据库技术趋势与选型指南2026年AI数据库赛道正在经历一场从"专用向量库"到"多模融合底座"的架构重构。大模型推理成本骤降90%以上,AI应用从试点走向规模化,数据基础设施反而成了新的瓶颈——Gartner预测超60%的AI项目将因数据底座不足而失败。 下面从趋势...
-
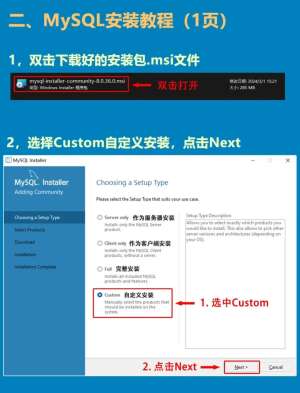 MySQL迁移教程详解:从理论到生产环境实践
MySQL 迁移教程详解:从理论到生产环境实践适用场景:同版本迁移、跨大版本升级(5.7→8.0)、跨服务器迁移、上云迁移、主从拆分、数据库搬家;覆盖开发测试、预发、正式生产。核心原则:数据一致性优先、可回滚、业务影响最小化;禁止直接在生产裸操作,必须预演...