HBase面试题常见问题排查手册
HBase 面试题常见问题排查手册
面向后端、大数据开发面试,分为:基础概念、读写原理、架构、RowKey
设计、预分区、版本与删除、集群运维、线上故障排查、对比题、高频手写题。每个问题附带【标准答案】+【面试加分点】,适合背诵 + 排查线上问题。
一、基础概念类
1. HBase 是什么?特点?
答:HBase 是 Hadoop 生态下,基于 HDFS 的分布式、面向列、有序的 NoSQL 数据库,来源于 Google Bigtable 论文。特点:
海量存储,支持 PB 级;
稀疏,空列不占存储空间;
面向列簇(ColumnFamily),不是面向列;
强有序:RowKey 字典序排序;
高吞吐随机读写;
支持多版本;
不支持二级索引(原生)、不支持复杂 SQL(Phoenix 是补充);
高可用。
加分:CAP 上属于 CP,优先保证一致性和分区容错,牺牲部分可用性。
2. HBase 和 HDFS 的区别
答
HDFS:分布式文件系统,适合大文件顺序读写,不支持随机单行查询,高延迟;
HBase:数据库,构建在 HDFS 之上;负责结构化数据、随机单行 / 范围查询;数据最终落地 HDFS 存 HFile。
3. HBase 和 MySQL 的区别
MySQL:关系型,行存储,支持事务、JOIN、二级索引;适合 OLTP,数据量千万级为主;
HBase:列簇存储,无事务(单行事务),原生无二级索引;适合海量数据、高并发写入、范围扫描,OLAP / 时序、画像、日志场景。加分:HBase 只有行原子性,多行不支持事务。
4. 列簇(ColumnFamily)理解,列簇设计原则
答:HBase 表由多个列簇组成,一个列簇下可以无限多 Qualifier(列)。同一列簇的数据存在一起,HFile 按列簇分离。设计原则:
列簇数量越少越好,一般 1~2 个,不建议超过 3 个;
访问模式相近的放同一个列簇;
列簇下列不要频繁变动;
不同列簇独立配置:版本数、TTL、压缩、块缓存。
面试坑:不要说 “面向列存储 = 一列一个文件”,是列簇。
二、架构核心(面试重中之重)
5. HBase 架构组件:Master、RegionServer、Zookeeper、HDFS 各自作用
Zookeeper(核心协调)
保存 meta 表位置(hbase:meta);
Master 故障转移(Active Master 选举);
RegionServer 注册、心跳、监控 RS 存活;
存储集群元信息、表锁。
HMaster
表 DDL:建表、删表、修改列簇;
Region 分配、负载均衡、Region 迁移;
故障转移:RS 宕机后,把它的 Region 重新分配给其他 RS;
不参与读写,读写不走 Master。
RegionServer(RS):真正负责读写的服务
管理多个 Region;
写:WAL 预写日志 + MemStore;
读:MemStore + BlockCache + HFile;
触发 Flush、Compact、Split;
HDFS:持久化 HFile、WAL 日志。
加分:读写流程不经过 Master,Master 只做管理,这是高吞吐关键。
6. Region 是什么?
Region 是 HBase 表的分片,一张表按 RowKey 范围切分成多个 Region;一个 Region 只属于一个 RS;一个 RS 管理多个 Region。 Region 由:一个 Store(每个列簇一个 Store),Store 由 MemStore + 多个 HFile。
7. WAL 预写日志作用
答:写入先写 WAL,再写 MemStore。作用:宕机恢复。RS 崩溃时,MemStore 数据还没 Flush 成 HFile,从 WAL 回放数据恢复。可选关闭 WAL(setDurability(SkipWal)),代价:宕机丢数据,一般用于可以重推的日志采集场景。
8. 写流程(标准面试口述版)
Client 先连 ZK,查 hbase:meta,找到该 RowKey 所在 Region、对应 RS;
Client 直接和 RS 通信;
先写 WAL(预写日志);
写入 MemStore(内存排序);
返回客户端成功;
MemStore 达到阈值,触发 Flush,生成 HFile 写入 HDFS。
关键点:写是追加,不修改 HFile,更新和删除都是打标记。
9. 读流程
查 meta 表定位 Region;
读顺序:先查 MemStore → 再查 BlockCache(读缓存)→ 最后读磁盘 HFile;
HFile 按 RowKey 有序,内部有索引,快速定位;
多版本合并,按版本、删除标记过滤,返回最新有效版本。
10. Flush、Split、Compact 分别是什么,触发条件
Flush:MemStore 内存满(默认 128M)→ 刷成 HFile;防止内存无限上涨。
Split:单个 Region 大小超过阈值(默认 10G),分裂成两个 Region,负载分散。
Compact 合并:把同一个 Store 下多个小 HFile 合并成大 HFile;清理删除标记、过期版本。
Minor Compaction:选部分 HFile 合并;
Major Compaction:合并全部 HFile,清理墓碑,IO 风暴风险很大,生产一般手动低峰执行。
高频踩坑:Major Compaction 容易打爆集群 IO,生产严禁自动 Major。
-
 HBase面试题常见问题排查手册
HBase 面试题常见问题排查手册面向后端、大数据开发面试,分为:基础概念、读写原理、架构、RowKey 设计、预分区、版本与删除、集群运维、线上故障排查、对比题、高频手写题。每个问题附带【标准答案】+【面试加分点】,适合背诵 + 排查线上问题。 一、基础概...
-
 2026年AI数据库学习笔记最新趋势与技术选型
2026年AI数据库技术趋势与选型指南2026年AI数据库赛道正在经历一场从"专用向量库"到"多模融合底座"的架构重构。大模型推理成本骤降90%以上,AI应用从试点走向规模化,数据基础设施反而成了新的瓶颈——Gartner预测超60%的AI项目将因数据底座不足而失败。 下面从趋势...
-
 MySQL迁移教程详解:从理论到生产环境实践
MySQL 迁移教程详解:从理论到生产环境实践适用场景:同版本迁移、跨大版本升级(5.7→8.0)、跨服务器迁移、上云迁移、主从拆分、数据库搬家;覆盖开发测试、预发、正式生产。核心原则:数据一致性优先、可回滚、业务影响最小化;禁止直接在生产裸操作,必须预演...
-
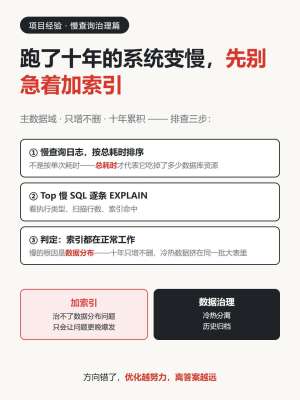 2026年Elasticsearch索引最新趋势与技术选型
2026 年 Elasticsearch 索引最新趋势与技术选型说明:以下信息主要依据 Elastic 官方 Blog(Elastic 9.4、9.5 版本,2026 年发布)与 Search Labs 技术内容整理,聚焦索引相关的趋势与选型,不含商业立场。一、2026 年整体趋势:从 "搜索数据库" 走向 "统一数据平台"Elasticsearch 2026 年的...
-
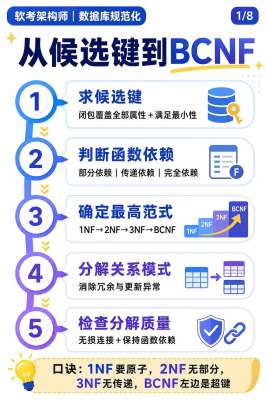 反范式教程:数据库高手进阶之路
反范式不是“把表设计乱”,而是在范式基础上,有目的地引入冗余,用空间换查询性能。高手和普通开发者的区别在于:普通人一上来就加冗余字段,高手会先确认瓶颈,再选最小冗余方案,并把一致性维护当成生产基础设施。1....
-
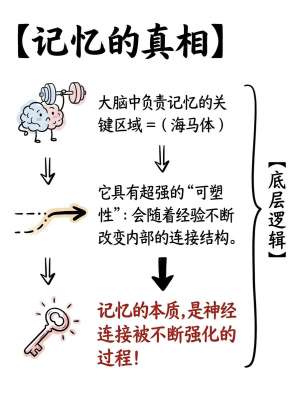 【深入浅出】进阶Memory,一文讲透核心原理
深入浅出 进阶 Memory 一文讲透核心原理大模型基础的上下文窗口存在短板,输入越长,越容易出现信息丢失 遗忘,上下文成本也会持续变高。Memory 记忆模块就是用来解决这个问题,让大模型拥有长期记忆,记住跨轮对话的信息,不再局限单次 prompt。一 什么是大模型...