2026年高级MVCC最新趋势与技术选型
既然您提到了“高级”,说明您已经对 MVCC(多版本并发控制)的基础概念(如隐藏字段、Undo Log、Read View)有了基本了解。在高级阶段,我们需要深入探讨 MVCC 的底层架构差异、与锁机制的协同、以及极端场景下的性能瓶颈。
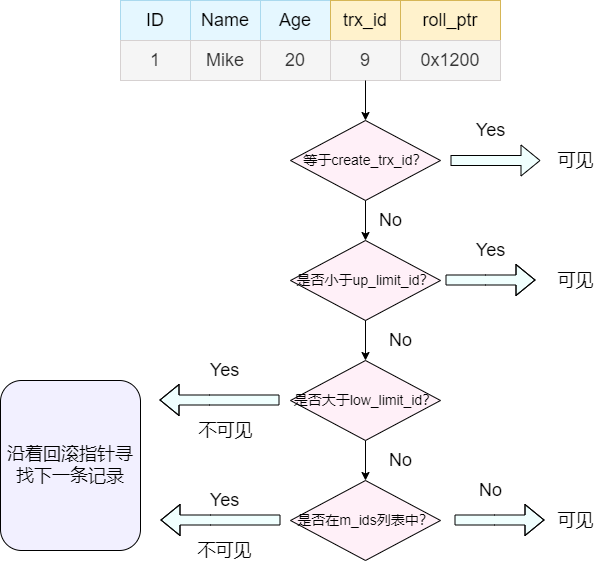
以下为您梳理的 MVCC 高级核心知识图谱:
一、 核心架构差异:版本存储与垃圾回收
不同数据库对 MVCC 的底层实现存在巨大差异,这直接决定了它们的性能特征和运维方式。目前主要分为两大流派:
原地更新 + Undo Log 重构(MySQL InnoDB / Oracle)
原理:主表中只保留最新版本的记录。当事务修改数据时,将旧版本存入 Undo Log,并通过回滚指针(Roll Pointer)串联成版本链。读取历史版本时,通过 Read View 动态重构。
特点:写入性能高(无需频繁移动数据),但长版本链会导致读取性能下降。
追加写入 + 多版本共存(PostgreSQL / Firebird)
原理:每次更新都会在表中直接插入一条新记录(Tuple),旧版本保留在表中直到被垃圾回收。通过 xmin(创建事务)和 xmax(删除/更新事务)字段判断可见性。
特点:读取最新版本极快(无需回溯),但写入开销大,且表体积膨胀严重,必须依赖 VACUUM 进程定期清理死元组(Dead Tuples)。
二、 隔离级别与锁机制的深度协同
MVCC 并非万能,它必须与锁机制配合才能完美解决事务隔离问题。以 InnoDB 的默认隔离级别 可重复读(RR) 为例:
快照读(Snapshot Read):完全依赖 MVCC。事务首次 SELECT 时生成 Read View 并复用,保证整个事务内读取的数据版本一致,彻底解决不可重复读。
当前读(Current Read):如 SELECT ... FOR UPDATE、UPDATE、DELETE。这些操作读取的是最新版本,不使用 MVCC,而是通过加排他锁(X锁)来保证并发安全。
解决幻读的终极武器(Next-Key Lock):在 RR 级别下,为了防止其他事务在范围内插入新数据导致“幻读”,InnoDB 在“当前读”时不仅锁住记录本身(Record Lock),还会锁住记录之间的间隙(Gap Lock)。这种临键锁(Next-Key Lock)与 MVCC 配合,构成了 InnoDB 强大的并发控制基石。
三、 高级性能瓶颈与调优
在实际生产环境中,MVCC 的不当使用会带来严重的性能问题:
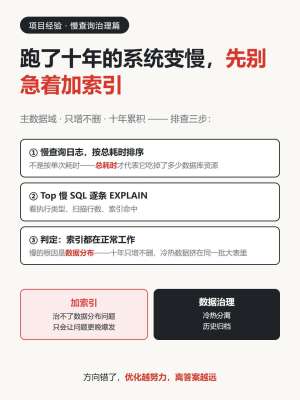
长事务导致版本链过长:如果一个事务长时间未提交,它引用的旧版本就无法被 Purge 线程清理。这会导致版本链变得极长,后续的查询需要沿着链表不断回溯,导致快照读性能急剧下降。
Undo Log 膨胀与空间复用失败:大量历史版本堆积会撑大 Undo Log 文件。如果 Purge 线程清理速度跟不上写入速度,会导致严重的磁盘 I/O 瓶颈。
最佳实践:
坚决避免大事务,保持事务短小精悍。
针对大批量的 DELETE/UPDATE 操作,务必分批处理,给 Purge 线程留出清理旧版本的时间。
密切监控数据库的 History list length(InnoDB 中未清理的 Undo Log 页数),该指标过高是 MVCC 压力的直接预警。
四、 前沿演进:无锁与内存级 MVCC
随着硬件发展,MVCC 也在不断演进:
内存级 MVCC(如 DuckDB / HyPer):针对分析型(OLAP)数据库,由于数据全在内存中,抛弃了传统的持久化 Undo Log,直接在内存中通过事务 ID 和时间戳(Start/Commit Timestamp)进行极速的可见性判断,甚至完全摒弃了 Read View 的开销。
乐观并发控制(MVOCC):假设事务冲突概率极低,将事务分为读、验证、写三个阶段,在提交时才进行冲突检测,从而将持锁时间压缩到最短(如 MemSQL、SQL Server Hekaton)。
-
 2026年Elasticsearch索引最新趋势与技术选型
2026 年 Elasticsearch 索引最新趋势与技术选型说明:以下信息主要依据 Elastic 官方 Blog(Elastic 9.4、9.5 版本,2026 年发布)与 Search Labs 技术内容整理,聚焦索引相关的趋势与选型,不含商业立场。一、2026 年整体趋势:从 "搜索数据库" 走向 "统一数据平台"Elasticsearch 2026 年的...
-
 反范式教程:数据库高手进阶之路
反范式不是“把表设计乱”,而是在范式基础上,有目的地引入冗余,用空间换查询性能。高手和普通开发者的区别在于:普通人一上来就加冗余字段,高手会先确认瓶颈,再选最小冗余方案,并把一致性维护当成生产基础设施。1....
-
 【深入浅出】进阶Memory,一文讲透核心原理
深入浅出 进阶 Memory 一文讲透核心原理大模型基础的上下文窗口存在短板,输入越长,越容易出现信息丢失 遗忘,上下文成本也会持续变高。Memory 记忆模块就是用来解决这个问题,让大模型拥有长期记忆,记住跨轮对话的信息,不再局限单次 prompt。一 什么是大模型...
-
 EXISTS手册详解:从理论到生产环境实践
EXISTS 手册详解:从理论到生产环境实践 一、EXISTS 是什么EXISTS 是一个布尔运算符,用于判断子查询是否返回至少一行数据。返回 TRUE 或 FALSE,不关心子查询返回的具体列内容。核心特性:短路评估(short-circuit)——子查询找到第一行匹配数据就立即返回 TRUE,终止扫描...
-
 Milvus怎么做常见问题排查手册
Milvus 怎么做常见问题排查手册 一 排查前置准备 先收集基础信息再定位问题避免盲目操作确认 Milvus 部署模式单机 docker k8s 或物理机记录 Milvus 版本客户端 sdk 版本操作系统信息获取基础运行状态包含服务进程日志资源指标整理业务相关信息查询语句写入参数集合 sc...
-
 【深入浅出】必看图数据库,一文讲透核心原理
一句话概括:图数据库不是存表格,而是存储「实体(节点 Node)+ 实体之间的关系(边 Edge)」,专门用来高效处理复杂关联查询,关系越多、关联越深,对比 MySQL 这类关系型数据库优势越明显。一、基础概念:节点、边、...