MySQL迁移教程详解:从理论到生产环境实践
MySQL 迁移教程详解:从理论到生产环境实践
适用场景:同版本迁移、跨大版本升级(5.7→8.0)、跨服务器迁移、上云迁移、主从拆分、数据库搬家;覆盖开发测试、预发、正式生产。核心原则:数据一致性优先、可回滚、业务影响最小化;禁止直接在生产裸操作,必须预演。前置知识:MySQL
基础、锁机制、binlog、事务、主键、字符集、时区;关联前面后端安全要点:迁移过程密钥、权限、审计日志不能丢。
一、底层理论先理清(很多迁移翻车根源在这里)
1. 迁移的本质是什么
迁移不是单纯复制 .ibd 文件。它包含四层:
元数据:库、表、视图、存储过程、函数、触发器、事件、权限、账号
业务数据:表行数据、自增 ID、外键关系
运行配置:字符集、排序规则、时区、sql_mode、innodb 参数
流量切换:应用连接地址、读写分离、缓存、中间件配置
2. 三种主流迁移方案底层原理对比
逻辑备份(mysqldump /mydumper)原理:服务端执行查询,把表数据 + DDL 导出成 SQL 文本;导入时重新执行建表、插入。优点:跨版本、跨操作系统、跨存储引擎,兼容性最好,可控粒度强。缺点:大数据量慢、导出导入期间会锁表(取决于参数)。适合中小库、跨版本升级。
物理备份(xtrabackup /mysqlpump 物理、冷拷贝 ibd)原理:直接复制 InnoDB 底层数据文件,配合 redo log 保证一致性,不需要解析 SQL。优点:速度极快,TB 级库首选。缺点:源和目标 MySQL 版本、架构、页面尺寸必须匹配;不能跨操作系统随意迁移,文件层面依赖 InnoDB。适合同版本、同架构大库。
增量同步(binlog 同步,主从复制 / Canal)原理:先做一次全量基线,再消费 binlog 回放增量变更,持续追平两边数据;业务切流前保持同步。优点:停机窗口最小,生产低停机迁移的标准方案。缺点:链路复杂,要处理主键冲突、DDL 同步、sql_mode 不一致、字符集问题。适合生产核心业务,要求短停。
3. 迁移风险底层根源(高频翻车点)
字符集、排序规则不一致:源 latin1,目标 utf8mb4,中文乱码、索引排序异常。 sql_mode 差异:MySQL5.7 默认宽松,8.0 默认严格,NO_ZERO_DATE、ONLY_FULL_GROUP_BY,导入直接报 SQL 错误。自增 ID、主键冲突:两边表同时写入,新 ID 碰撞。外键约束、触发器、事件忘记迁移,业务逻辑残缺。时区不一致:时间字段 timestamp、datetime 出现时差。权限漏迁移:应用账号、只读账号、备份账号丢失,迁移完程序连不上。缓存脏数据:Redis、本地缓存没有清空,切换后读旧数据。约束:任何迁移方案都绕不开 “一致性”,要么锁库停写拿到一致性快照,要么用 binlog 做持续同步。
二、迁移前检查清单(生产必做,顺序不能省)
版本评估 5.7 迁移到 8.0 属于跨大版本,有大量语法、权限、缓存表、密码插件变更,必须在预发环境完整跑一轮验证;不建议直接线上直迁。
信息收集库名、表清单、存储过程、函数、触发器、定时 event、用户账号、IP 白名单。记录源库参数:character_set、collation、time_zone、sql_mode、innodb_page_size。
业务评估读写量、QPS、是否有大事务、大表、无主键表(binlog 同步对无主键表非常不友好)。无主键表优先提前增加主键,否则增量同步延迟巨大。
预发环境复刻拿一份源库备份,在预发库完整跑一次导出、导入、校验、压测,记录耗时和报错。预发验证通过,才允许上生产。
备份兜底迁移开始前,源库做一份独立全量备份,异地留存,作为回滚底座。没有备份,不启动迁移。
应用侧准备准备切换开关:配置中心改数据库地址;准备回滚方案,随时切回源库。通知业务,准备维护窗口。
三、方案一:mysqldump 逻辑迁移(中小库、跨版本首选,新手友好)
适合:几十 G 以内,跨 5.7→8.0,表结构复杂、有存储过程视图。
导出命令(带一致性快照,InnoDB)
mysqldump -h源地址 -uroot -p
--single-transaction
--routines
--triggers
--events
--default-character-set=utf8mb4
--databases dbname > dump.sql
参数说明 --single-transaction:InnoDB 不加锁,依靠 MVCC 拿到一致性快照,业务可以不停写(但导出期间持续有新数据,后面需要补增量) --routines --triggers --events:导出存储过程、触发器、定时事件,很多人漏掉 --databases:会自带 CREATE DATABASE 语句;如果目标库库名不一样,去掉,导入前手动建库。
注意:MyISAM 引擎不支持 single-transaction,导出会锁表。
传输文件
scp 把 dump.sql 传到目标服务器;大文件可以压缩
mysqldump ... | gzip > dump.sql.gz
# 导入
gzip -d dump.sql.gz
mysql -h目标 -uroot -p dbname < dump.sql
单独迁移账号权限(mysqldump 不导出用户)
用户权限存在 mysql 系统库,单独导出权限 SQL:
mysqlpump --users > user_grant.sql
在目标库执行 user_grant.sql 重建账号,注意密码插件:8.0 默认 caching_sha2_password,老客户端不支持,可以创建时指定 IDENTIFIED WITH mysql_native_password。
数据校验
导入完成后,核对:表数量、总行数、最大自增 ID、核心业务表抽样比对。简单校验脚本思路:源库、目标库对同一张表 count,对比;或者校验和 CHECKSUM TABLE table_name。
四、方案二:XtraBackup 物理热备迁移(大库,百 GB/TB 级,同版本优先)
Percona XtraBackup,InnoDB 物理备份,不锁表(8.0 用 xtrabackup8)
全量备份源库
xtrabackup --user=root --password=xxx --backup --target-dir=/data/backup/full
准备备份(apply redo log,让文件达到一致状态)
xtrabackup --prepare --target-dir=/data/backup/full
把整个备份目录传到目标服务器
停目标 MySQL,清空数据目录,把备份文件拷贝到 datadir,修改文件属主 mysql:mysql
启动 MySQL
硬性限制:源和目标 MySQL 大版本一致、innodb_page_size 一致;跨版本 5.7→8.0 不推荐物理直拷,容易启动崩溃。
五、方案三:binlog 增量同步迁移(生产低停机方案|重点)
适用:核心业务,停机窗口要求很短,比如只允许几分钟维护。整体流程:
业务低峰,做一次 mysqldump/xtrabackup 全量基线,导入目标库
搭建主从复制:源作为 master,目标作为 slave,同步 binlog,持续追赶增量数据
持续观察 Seconds_Behind_Master 延迟,直到延迟接近 0
择维护窗口:业务停写,确认两边 binlog 位点完全对齐
校验数据,修改应用配置切流量到目标库
观察一段时间,稳定后,再下线源库
关键细节:
迁移前核对两边 sql_mode、字符集、时区,不一致同步会报异常
有 DDL(ALTER TABLE)时,同步链路很容易卡住,尽量迁移窗口前暂停业务 DDL
切换之后,不要立刻删掉源库,保持双写只读一段时间,作为回滚源
备选工具:Canal、Debezium,适合异构同步,或者不想搭建原生主从的场景,比如同步到分析库。
六、迁移后验证步骤(标准化)
基础层 MySQL 正常启动,无 error 日志;账号权限正常,应用能连接。
结构层表、字段、索引、视图、存储过程、触发器、事件全部存在,DDL 一致。
数据层核心表行数、校验和、抽样业务记录核对;时间字段、中文内容无乱码。
业务层应用完整跑通:注册、查询、下单、支付等核心链路;读写正常,事务提交无报错。
监控层 QPS、慢查询、连接数、锁等待、报错指标,和迁移前对比,没有异常飙升。
缓存清理 Redis 相关缓存清空或者失效,防止读到旧数据。
七、生产切换策略与回滚方案(重中之重)
两种切换模式
直接切(简单业务):改配置指向新库;一旦发现问题,立刻改回源库。前提:源库保持只读,不销毁。
双写(高重要业务):应用层短暂双写新旧两个库,数据双向对齐,校验稳定后切读流量,最后停旧库写入。实现成本更高,一致性保障更强。
回滚触发条件:数据错乱、大量报错、性能崩盘。回滚动作:切回应用地址到源库;源库之前没有停服的话,业务快速恢复;如果源库已经停写,依赖之前的离线备份恢复。
八、常见坑与排错
导入报错:Invalid default value for datetime 原因:目标 sql_mode 开启 NO_ZERO_DATE。解决方案:导入前临时调整 sql_mode,或者修改表字段默认值。
中文乱码核对库、表、连接客户端三层字符集统一为 utf8mb4,不要混用 utf8。
密码登录失败(迁移 5.7 用户到 8.0) 8.0 默认认证插件变了,老客户端不支持 caching_sha2_password,重建账号指定 mysql_native_password。
增量同步卡住,延迟越来越大优先检查:无主键表、大事务 DDL、索引缺失、磁盘 IO 瓶颈、网络带宽。
导入成功,但是程序查不到新数据忘记刷新应用缓存、或者读写分离从库还没追上主库。
九、安全相关(结合后端安全)
迁移包(dump.sql)里面包含明文数据,传输、存放要加密,不要随便传到公网;迁移完成后,清理临时备份文件、临时账号;迁移前后开启审计日志,记录账号登录、DDL 变更;目标库沿用最小权限原则,不要直接给业务 root 账号。
十、路线总结
小库跨版本 → mysqldump 逻辑导出导入;同版本 TB 级大库 → XtraBackup 物理备份;生产核心业务,要求短停机 → 全量基线 + binlog 增量同步 + 主从追平 + 切换; 永远先预演、先备份、准备回滚,再动手生产迁移。
-
 MySQL迁移教程详解:从理论到生产环境实践
MySQL 迁移教程详解:从理论到生产环境实践适用场景:同版本迁移、跨大版本升级(5.7→8.0)、跨服务器迁移、上云迁移、主从拆分、数据库搬家;覆盖开发测试、预发、正式生产。核心原则:数据一致性优先、可回滚、业务影响最小化;禁止直接在生产裸操作,必须预演...
-
 2026年Elasticsearch索引最新趋势与技术选型
2026 年 Elasticsearch 索引最新趋势与技术选型说明:以下信息主要依据 Elastic 官方 Blog(Elastic 9.4、9.5 版本,2026 年发布)与 Search Labs 技术内容整理,聚焦索引相关的趋势与选型,不含商业立场。一、2026 年整体趋势:从 "搜索数据库" 走向 "统一数据平台"Elasticsearch 2026 年的...
-
 反范式教程:数据库高手进阶之路
反范式不是“把表设计乱”,而是在范式基础上,有目的地引入冗余,用空间换查询性能。高手和普通开发者的区别在于:普通人一上来就加冗余字段,高手会先确认瓶颈,再选最小冗余方案,并把一致性维护当成生产基础设施。1....
-
 【深入浅出】进阶Memory,一文讲透核心原理
深入浅出 进阶 Memory 一文讲透核心原理大模型基础的上下文窗口存在短板,输入越长,越容易出现信息丢失 遗忘,上下文成本也会持续变高。Memory 记忆模块就是用来解决这个问题,让大模型拥有长期记忆,记住跨轮对话的信息,不再局限单次 prompt。一 什么是大模型...
-
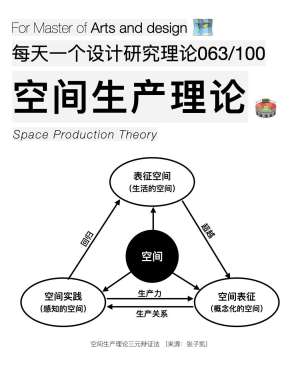 EXISTS手册详解:从理论到生产环境实践
EXISTS 手册详解:从理论到生产环境实践 一、EXISTS 是什么EXISTS 是一个布尔运算符,用于判断子查询是否返回至少一行数据。返回 TRUE 或 FALSE,不关心子查询返回的具体列内容。核心特性:短路评估(short-circuit)——子查询找到第一行匹配数据就立即返回 TRUE,终止扫描...
-
 Milvus怎么做常见问题排查手册
Milvus 怎么做常见问题排查手册 一 排查前置准备 先收集基础信息再定位问题避免盲目操作确认 Milvus 部署模式单机 docker k8s 或物理机记录 Milvus 版本客户端 sdk 版本操作系统信息获取基础运行状态包含服务进程日志资源指标整理业务相关信息查询语句写入参数集合 sc...