2026年AI数据库学习笔记最新趋势与技术选型
2026年AI数据库技术趋势与选型指南
2026年AI数据库赛道正在经历一场从"专用向量库"到"多模融合底座"的架构重构。大模型推理成本骤降90%以上,AI应用从试点走向规模化,数据基础设施反而成了新的瓶颈——Gartner预测超60%的AI项目将因数据底座不足而失败。
下面从趋势、选型、落地三个维度展开。
一、2026年四大核心趋势
趋势1:从"外挂向量库"走向"多模融合内核"
传统RAG架构需要维护向量库、全文库、图谱库三套独立系统,数据同步延迟可达分钟级,硬件成本是单库方案的2.3倍。 2026年的主流方向是一库多能——在统一内核中融合关系型、向量、图、文档等多种数据模型,通过统一查询规划器实现跨模融合检索。韩国KAIST团队开发的AkasicDB实验显示,这种架构可将响应准确率提升78%,处理速度提升20倍以上。
趋势2:向量检索从"附加功能"变成"核心能力"
PostgreSQL通过pgvector扩展已成为AI时代数据库选型的焦点——在100万向量规模下,HNSW索引的pgvector延迟已能匹配专用向量数据库。 AWS、阿里云等云厂商纷纷在现有数据库产品中植入向量能力,Amazon DynamoDB、ElastiCache、Neptune均已支持向量检索。 这印证了AWS数据库负责人G2的判断:重构不是唯一选择,渐进式增强同样有效。
趋势3:GraphRAG成为下一代RAG标准
单纯向量相似度检索在面对复杂查询时力不从心,知识图谱的关系推理能力正在被纳入RAG流水线。通过向量检索+图遍历的联合查询,某金融舆情分析场景中事件关联准确率从68%提升至89%。 北京大学王选所等研究机构正将图数据库作为支撑Agent记忆和大规模知识图谱的关键基石。
趋势4:数据库成为Agent的"记忆海绵"
AI Agent与传统程序的根本区别在于拥有上下文和长期记忆。数据库角色正从被动存储演变为Agent的记忆管理系统——不仅要存数据,还要懂语义、做推理、管理会话状态。 这直接推动了MCP(模型上下文协议)的普及,让各类数据库都能被Agentic框架顺畅访问。
二、技术选型:按场景对号入座
当前向量数据库市场可归纳为三条路线,选型的第一原则是从场景出发,而非从性能榜单出发。
专用向量数据库(Milvus / Qdrant / Weaviate / Pinecone)
Milvus:CNCF毕业项目,分布式架构,支持十亿级向量和GPU加速,索引类型最全(HNSW/IVF/DiskANN等)。国内团队Zilliz维护,中文文档齐全,生态集成最好。缺点是组件多(etcd+MinIO+Milvus),运维门槛高,版本迭代快API变动频繁。
Qdrant:Rust实现,内存安全且资源占用低,过滤检索能力极强(原生支持payload过滤而非先检索再过滤)。在100M向量基准测试中召回率最高(0.991),P99延迟12ms。部署简单(单容器即可),但社区版不支持分布式,中文资料较少。
Weaviate:模块化设计,内置多个embedding模型,原生支持BM25+向量混合检索,GraphQL API灵活。缺点是资源消耗较高,国内社区几乎无人使用。
Pinecone:全托管SaaS,零运维,Serverless按量计费。缺点是闭源、数据需传海外服务器(国内金融/政务合规直接pass),长期成本最高(100万向量月费约$70,自建Milvus同等规模月成本不到$15)。
关系型数据库扩展(pgvector / 国产融合库)
pgvector:PostgreSQL扩展,零成本接入,完整ACID事务支持,向量检索和关系查询在同一SQL中完成。100万向量下HNSW索引性能已匹敌专用库。缺点是单机性能瓶颈明显,超过5000万向量需谨慎评估,插入操作比专用库慢。
国产融合数据库:如人大金仓KES、海量数据Vastbase V100、崖山YashanDB等,在内核层面融合关系+向量+图能力,支持信创适配和国密算法,适合金融/政务等强监管行业。
嵌入式/轻量级库(Chroma / LanceDB / FAISS)
Chroma:pip install即用,开发体验最佳,适合原型验证和个人项目。缺点是无分布式支持,高并发稳定性不足,100M向量下QPS仅890。
FAISS:Facebook开源的检索库(非数据库),支持GPU加速,检索速度行业标杆。但无元数据存储和事务能力,需自建服务层。
三、选型决策框架
建议按四个维度依次判断:
数据规模:10万-1000万向量选Qdrant或pgvector;1000万-亿级选Milvus或Weaviate;亿级以上首选Milvus。
关联复杂度:向量与业务数据(订单、权限、设备台账)强关联且需要事务一致性,优先pgvector或国产融合库;纯向量检索场景专用库更优。
运维能力:有K8s和SRE团队可选Milvus自建;中小团队追求性价比选Qdrant;零运维需求且预算充足选Pinecone或Zilliz Cloud。
合规要求:国内金融/政务/能源等信创场景,优先国产融合数据库(KES/Vastbase/YashanDB),规避数据出境和供应链风险。
四、落地路线图
原型验证阶段:用Chroma或Pinecone快速搭建,2周内跑通RAG流程。
生产化阶段:根据数据量和合规要求选定正式方案,建立向量生成→索引构建→检索优化的标准化Pipeline。
进阶阶段:引入GraphRAG(向量+图谱联合检索)、混合检索(关键词+语义)、Rerank重排,持续提升检索质量。
平台化阶段:将向量能力内嵌至企业统一数据底座,实现"一次写入、多模查询",消除数据同步链路。
一句话总结:2026年AI数据库的核心矛盾已从"能不能做向量检索"转向"如何以最低复杂度支撑多模融合查询"。小规模场景pgvector或Qdrant是性价比之选,大规模生产环境Milvus仍是开源首选,信创合规场景国产融合库正在快速成熟。
-
 2026年AI数据库学习笔记最新趋势与技术选型
2026年AI数据库技术趋势与选型指南2026年AI数据库赛道正在经历一场从"专用向量库"到"多模融合底座"的架构重构。大模型推理成本骤降90%以上,AI应用从试点走向规模化,数据基础设施反而成了新的瓶颈——Gartner预测超60%的AI项目将因数据底座不足而失败。 下面从趋势...
-
 MySQL迁移教程详解:从理论到生产环境实践
MySQL 迁移教程详解:从理论到生产环境实践适用场景:同版本迁移、跨大版本升级(5.7→8.0)、跨服务器迁移、上云迁移、主从拆分、数据库搬家;覆盖开发测试、预发、正式生产。核心原则:数据一致性优先、可回滚、业务影响最小化;禁止直接在生产裸操作,必须预演...
-
 2026年Elasticsearch索引最新趋势与技术选型
2026 年 Elasticsearch 索引最新趋势与技术选型说明:以下信息主要依据 Elastic 官方 Blog(Elastic 9.4、9.5 版本,2026 年发布)与 Search Labs 技术内容整理,聚焦索引相关的趋势与选型,不含商业立场。一、2026 年整体趋势:从 "搜索数据库" 走向 "统一数据平台"Elasticsearch 2026 年的...
-
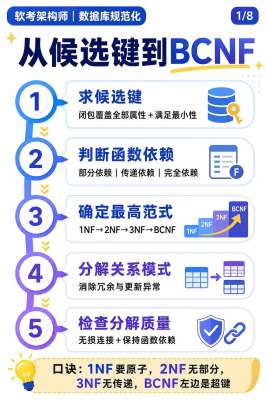 反范式教程:数据库高手进阶之路
反范式不是“把表设计乱”,而是在范式基础上,有目的地引入冗余,用空间换查询性能。高手和普通开发者的区别在于:普通人一上来就加冗余字段,高手会先确认瓶颈,再选最小冗余方案,并把一致性维护当成生产基础设施。1....
-
 【深入浅出】进阶Memory,一文讲透核心原理
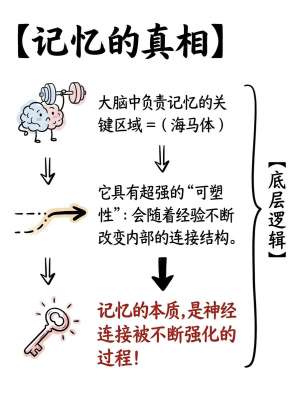
深入浅出 进阶 Memory 一文讲透核心原理大模型基础的上下文窗口存在短板,输入越长,越容易出现信息丢失 遗忘,上下文成本也会持续变高。Memory 记忆模块就是用来解决这个问题,让大模型拥有长期记忆,记住跨轮对话的信息,不再局限单次 prompt。一 什么是大模型...
-
 EXISTS手册详解:从理论到生产环境实践
EXISTS 手册详解:从理论到生产环境实践 一、EXISTS 是什么EXISTS 是一个布尔运算符,用于判断子查询是否返回至少一行数据。返回 TRUE 或 FALSE,不关心子查询返回的具体列内容。核心特性:短路评估(short-circuit)——子查询找到第一行匹配数据就立即返回 TRUE,终止扫描...