为什么推荐K8s部署实战?深度对比与实测
推荐 K8s 部署实战,核心不是因为它“听起来高级”,而是它能把部署效率、资源利用率、故障恢复、AI 算力调度、云原生生态一起拉高。 2026
年之后,K8s 已经不只是 Web 应用部署工具,正在成为 AI 推理、GPU 调度、平台工程、GitOps 的基础设施底座。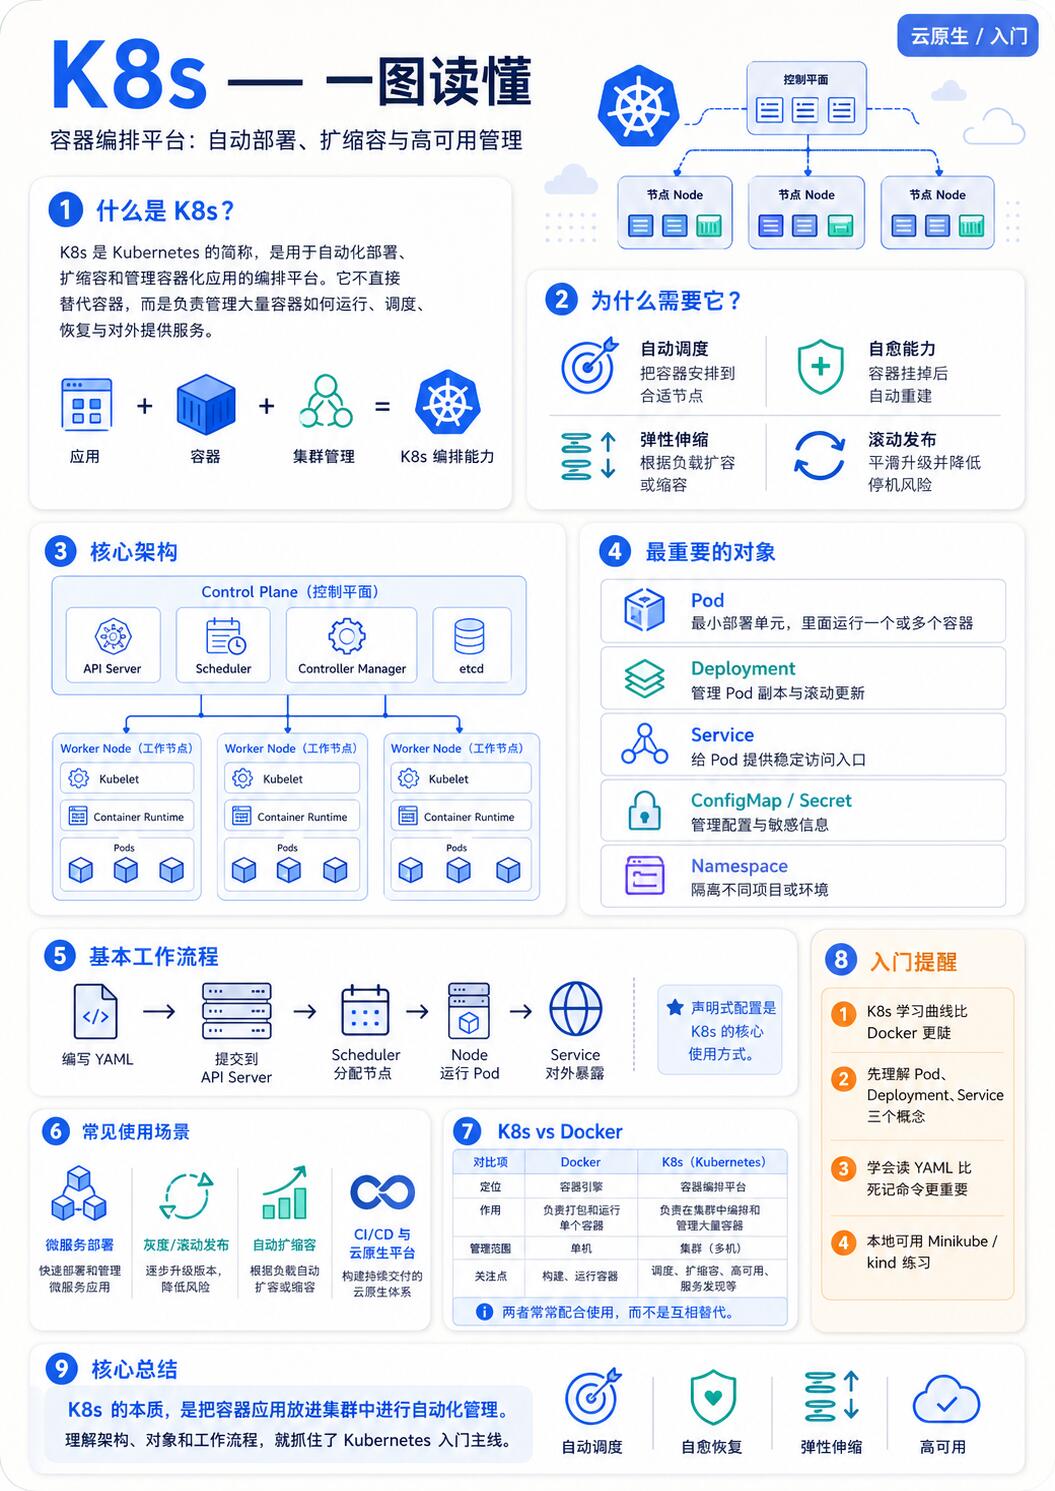
一、为什么值得做 K8s 实战
部署效率更高
用 Helm 或声明式配置部署全栈服务,通常可以压缩到分钟级甚至几十秒级;传统 VM 部署往往需要手动装环境、配依赖、启服务。
资源利用率更好
容器化让多个服务共享节点资源,配合 requests/limits、HPA、Cluster Autoscaler,能把 CPU 和内存从“长期预留但用不满”变成“按需分配”。
故障恢复更快
Pod 异常、节点故障、服务不可用时,K8s 能自动重建、迁移、摘流。相比传统虚拟机人工恢复,自愈能力更明显。
更适合 AI 与大模型场景
GPU 推理、批处理、模型服务扩缩容,天然需要精细化调度、弹性伸缩和资源隔离。2026 年 AWS EKS、阿里云 ACK 等平台都在强化 GPU 调度、Karpenter、EKS Capabilities 等能力。
生态和岗位需求更强
相比 Docker Swarm,K8s 在自动扩缩、服务网格、Helm、GitOps、监控告警、多云/混合云方面的生态更成熟。
二、实测对比怎么看
集群初始化
Docker Swarm 通常一条命令就能初始化集群,速度很快;K8s 需要安装 kubeadm、kubelet、kubectl 并初始化控制平面,耗时更长。
服务调度
小集群里 Swarm 的调度延迟往往更低;K8s 因为调度器、CNI、控制平面组件更多,首次调度可能稍慢。
大规模部署能力
当集群规模扩大、服务数量增加时,K8s 优势更明显。大规模场景下,K8s 部署大量 Pod 通常比 Swarm 更快,调度吞吐量也更高。
故障恢复
节点故障后,K8s 通常能在数十秒内完成 Pod 重建或迁移;Swarm 也能恢复,但高级自愈和调度能力相对弱。
资源开销
Swarm 控制平面更轻,内存占用低;K8s 控制平面组件更多,资源占用更高,但换来的是更强的调度、安全和扩展能力。
自动伸缩
K8s 内置 HPA、VPA、Cluster Autoscaler,能根据指标自动扩缩;Swarm 主要依赖手动扩缩副本,自动化能力弱。
安全与权限
K8s 提供 RBAC、NetworkPolicy、PodSecurity、Secret 管理等细粒度控制;Swarm 有基础 TLS 和 Secret 能力,但精细度不足。
灰度发布
K8s 支持滚动发布、蓝绿发布、金丝雀发布,配合 Argo Rollouts、Flagger 等工具更成熟;Swarm 主要支持滚动更新,流量控制能力有限。
三、K8s 实战最能练到的能力
声明式部署
学会用 Deployment、Service、Ingress、ConfigMap、Secret、PVC 描述应用期望状态。
资源与弹性管理
掌握 requests/limits、HPA、VPA、Cluster Autoscaler,理解不设资源限制会导致节点雪崩。
可观测性建设
把日志、指标、链路追踪接入 Prometheus、Grafana、SLS/ELK,而不是只靠 kubectl logs。
发布与回滚
实践滚动发布、灰度发布、蓝绿发布,理解如何在不中断业务的前提下上线新版本。
安全与权限
学会 RBAC、PodSecurity、镜像版本固定、网络策略、Secret 管理。
四、新手最容易踩的坑
所有服务塞进一个集群,生产、测试、AI 任务没有隔离。
不给容器设置资源限制,容易引发 OOM 和节点过载。
把 MySQL、Redis、Kafka 等有状态服务直接跑在 K8s 里,优先用托管版更稳。
用 NodePort 直接暴露公网,生产环境更推荐 Ingress + 负载均衡。
镜像过大、使用 latest 标签,导致发布慢、不可回滚。
日志写本地磁盘,Pod 重建后日志丢失。
不配健康检查,流量可能打到未就绪服务。
缺少监控和告警,故障排查会非常被动。
五、更稳的实战路径
先用 Minikube、Kind 或云托管 K8s 跑一个简单 Web 应用。
把应用拆成 Deployment + Service + Ingress。
加上资源限制、健康检查、滚动发布。
接入 Prometheus + Grafana 或云监控。
接日志系统,验证 Pod 重启后日志不丢。
实践 HPA 自动扩缩容。
再尝试灰度发布、GitOps、GPU 推理等进阶场景。
一句话总结:Swarm 适合小团队、小集群、快速上线;K8s 适合大规模、高可用、自动化和长期演进。做 K8s 部署实战,练的不只是“会部署”,而是把声明式运维、弹性、可观测、发布治理和安全控制一起补齐。
-
 为什么推荐K8s部署实战?深度对比与实测
推荐 K8s 部署实战,核心不是因为它“听起来高级”,而是它能把部署效率、资源利用率、故障恢复、AI 算力调度、云原生生态一起拉高。 2026 年之后,K8s 已经不只是 Web 应用部署工具,正在成为 AI 推理、GPU 调度、平台工程、GitOps 的基础设施底座。 一、为什么值得...
-
 一文掌握Hyper-V替代方案,效率提升300%
一文掌握 Hyper-V 替代方案,效率提升 300% 一句话总纲:Hyper-V 是 Windows 原生虚拟化,优势是系统自带、免费;短板是图形体验差、跨平台弱、快照笨重、资源调度不够灵活。下面按本地桌面开发、服务器生产、轻量容器、苹果电脑四类场景整理替代方案,附带优缺点、...
-
 一文掌握SSH免密登录,效率提升300%
一文掌握 SSH 免密登录:从配置到提速的完整方案SSH 免密登录本质是用公钥认证替代密码认证:本地生成密钥对,把公钥放到服务器的 ~/.ssh/authorized_keys,连接时客户端用私钥证明身份,服务端用公钥验证通过后直接放行。配置成功后,配合 ~/.ssh/config 别名和连接复...
-
 rsyslog精选详解:从入门到生产环境实践
rsyslog 精选详解:从入门到生产环境实践rsyslog 是 Linux 平台主流高性能日志采集转发服务,是 syslog 标准的增强实现;替代老式 syslogd,支持多输入、过滤、模板、转发、本地落盘、协议转发(UDP/TCP/TLS/RELP)、队列缓冲,广泛用于服务器、中间件、集群统一日志归集,常...
-
 故障转移故障排查手册:常见报错一站式解决
故障转移(Failover)涉及的组件很多,但排查思路其实高度一致:先确认“是否真的触发了故障转移”,再定位“触发原因”,最后验证“切换后是否可用”。下面按通用排查流程 + 高频组件报错整理,适合做运维手册直接复...
-
 一文掌握内核参数入门教程,效率提升300%
一文掌握内核参数入门教程,效率提升 300%说明:不是随便调参数就能凭空涨 3 倍性能,标题是圈内常见宣传口径;真实收益是:消除内核瓶颈、避免 OOM、软中断飙高、连接丢包、文件句柄耗尽这类隐性卡点,业务在高并发下不再被操作系统拖后腿。适合 Linux 服务器...