【实战】滚动更新大全,一步步带你搞定
既然你具备网站开发与运维的底层能力,那我们就跳过基础的“重启服务”概念,直接从Kubernetes 架构设计、流量调度和高可用保障的角度,为你梳理一份生产级的“滚动更新(Rolling Update)”大全。

在现代云原生架构中,滚动更新不仅仅是一个命令,它是一套结合了健康检查、流量控制和优雅终止的精密系统工程。以下是四个核心维度的深度解析:
核心机制:零停机的底层逻辑
滚动更新的本质是“先起新,后杀旧”。Kubernetes 通过控制 ReplicaSet 的扩缩容来实现这一过程,而不是直接修改 Pod。
创建新 ReplicaSet:当你触发更新(如修改镜像版本),K8s 会创建一个新的 ReplicaSet。
渐进式替换:系统会根据策略,逐步增加新 ReplicaSet 的副本数,同时减少旧 ReplicaSet 的副本数。
健康检查卡点:这是最关键的一步。新 Pod 必须通过 Readiness Probe(就绪探针) 后,才会被加入 Service 的 Endpoints,开始接收流量。如果新 Pod 启动失败或探针不通过,更新会自动暂停,旧 Pod 继续服务,确保业务不中断。
关键参数:控制更新节奏的“油门”与“刹车”
在 Deployment 的 strategy.rollingUpdate 中,有两个参数决定了更新的激进程度:
表格
下载为表格
导出为图片
参数含义生产环境建议
maxSurge更新过程中,允许超出期望副本数的最大 Pod 数量。设为 1 或 25%。这决定了你能多快启动新实例。
maxUnavailable更新过程中,允许低于期望副本数的最大 Pod 数量。核心业务建议设为 0。确保任何时刻都有足够的实例处理流量,实现真正的零停机。
保守策略:maxSurge: 1, maxUnavailable: 0。适合金融、支付等对可用性要求极高的场景,但更新速度较慢。
激进策略:maxSurge: 25%, maxUnavailable: 25%。适合非核心业务或测试环境,更新速度快,但会有短暂的容量波动。
运维保障:优雅终止与回滚
更新不仅仅是“启动新容器”,“杀死旧容器”的过程同样充满陷阱。
优雅终止(Graceful Shutdown):
当 K8s 决定终止一个旧 Pod 时,会先发送 SIGTERM 信号。
关键动作:此时应用应停止接收新请求,并处理完当前正在进行的请求。
PreStop Hook:建议在容器中配置 preStop 钩子(如 sleep 5),给负载均衡器(如 Nginx/Ingress)一点时间,让它感知到 Pod 即将下线并从转发列表中移除,防止请求被发送到正在关闭的 Pod 上导致 502 错误。
如果超过 terminationGracePeriodSeconds(默认30秒)进程仍未退出,K8s 会发送 SIGKILL 强制杀死。
安全回滚:
如果新版本出现严重 Bug,不要试图“修复后重新发布”,直接使用 kubectl rollout undo deployment/回滚到上一个稳定版本。
K8s 会保留历史 ReplicaSet(默认保留10个),回滚操作本质上是一次反向的滚动更新,速度非常快。
进阶策略:超越基础滚动更新
当你的业务规模扩大,基础的滚动更新可能无法满足更精细的流量控制需求。
蓝绿部署(Blue-Green):
原理:维护两套完全相同的环境(Blue 和 Green)。新版本部署在 Green,验证无误后,通过修改 Service 的 Selector,瞬间将所有流量切到 Green。
优势:切换是秒级的,且回滚只需切回 Selector,风险极低。
劣势:需要双倍资源,成本较高。
金丝雀发布(Canary Release):
原理:先部署少量新版本 Pod(如 10% 的流量),观察一段时间(如错误率、延迟是否正常),确认无误后再逐步扩大比例,直到 100%。
优势:将风险控制在最小范围,适合核心业务的重大变更。
工具:原生 K8s 实现较繁琐,推荐使用 Argo Rollouts 或 Flagger 等工具,它们能自动分析 Prometheus 指标并决定是继续发布还是自动回滚。
避坑指南:
单副本陷阱:如果你的 replicas: 1,即使设置了 maxUnavailable: 0,滚动更新也必然会有短暂停机,因为必须杀掉旧 Pod 才能腾出资源起新 Pod。生产环境核心服务至少 2 副本。
探针配置:readinessProbe 的 initialDelaySeconds 要设置合理,避免应用还没启动完就被判定为失败;periodSeconds 不要太长,确保应用异常时能迅速从流量中摘除。
-
 为什么推荐全站加速?深度对比与实测
全站加速(通常被称为 WSA、ECDN 或 ICDN)是一种融合了动态加速和静态加速的网站加速解决方案。它专门针对动静态内容混合的网站,能够同时解决静态资源加载慢和动态请求延迟高的问题。核心原理:动静分离与智能路由全站加速的核心在于“动静分离”和“智能路由...
-
 SRE面试速成详解:从入门到生产环境实践
SRE(站点可靠性工程)面试的核心,在于考察你是否具备“用软件工程思维解决运维问题”的能力。结合你平时对软件开发技术和前沿科技资讯的关注,以下为你梳理了一份高效的 SRE 面试速成指南:核心思维:SRE 到底在做什么?SRE 不是传统的运维,而是“当软件工程师...
-
 Jenkins安全加固教程最佳实践:资深运维的私藏技巧
文库里暂时没有收录 Jenkins 安全加固的专题文档,视频资源也未检索到。下面我基于 Jenkins 官方文档和 SANS 的加固指南,为你整理一份可直接落地的教程,并在文末附上官方权威文档链接供你收藏。第一道防线:启用并收紧认证授权Jenkins 默认安装后处于“裸奔”状...
-
 Nginx详解:从入门到生产环境实践
Nginx(发音为 "engine X")是一款开源的高性能 Web 服务器和反向代理服务器。它由俄罗斯程序员 Igor Sysoev 于 2004 年发布,最初是为了解决高并发场景下的 C10K 问题(即单机支持 1 万并发连接)而设计的。凭借极低的资源消耗和卓越的并发处理能力,Nginx 已成为现代互联网架...
-
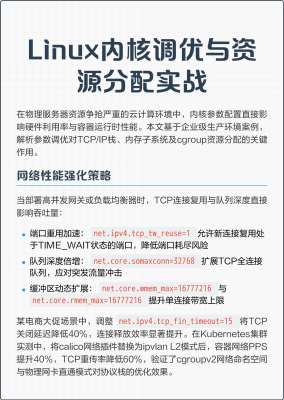 内核调优错误解决最佳实践:资深运维的私藏技巧
内核调优是一个“牵一发而动全身”的过程,出现错误通常是因为参数设置超出了系统承受范围,或者参数之间存在冲突。由于你没有提供具体的报错信息,我为你梳理了一套通用的内核调优错误排查与解决流程,涵盖了从紧急恢复到根因分析的完整路径:第一步:...
-
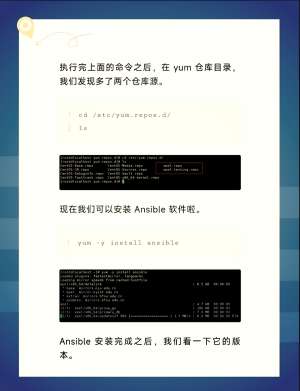 2026年Ansible部署教程最新教程,运维必收藏
Ansible 从安装到实战的完整部署教程,涵盖核心概念、环境搭建、Playbook 编写和最佳实践。核心概念速览表格下载为表格导出为图片概念说明Control Node运行 Ansible 的主机(不能是 Windows)Managed Nodes被 Ansible 管理的目标主机Inventory主机清单文件,定义被管理主机的地址和分...