【深入浅出】必看图数据库,一文讲透核心原理
【深入浅出】必看图数据库,一文讲透核心原理
一句话概括:图数据库不是存表格,而是存储「实体(节点 Node)+ 实体之间的关系(边
Edge)」,专门用来高效处理复杂关联查询,关系越多、关联越深,对比 MySQL 这类关系型数据库优势越明显。
一、基础概念:节点、边、属性
图(Graph)两大核心组成:
节点 Node(顶点 Vertex):代表实体。比如人、商品、账号、设备、文章。节点可以带属性:例如用户节点,属性有 id、姓名、年龄。
边 Edge(关系 Relationship):连接两个节点,代表实体之间的关联,边自带方向、类型、属性。例:张三 →[好友]→李四;商品A →[推荐]→商品B;员工 →[从属]→部门。
对比关系库 MySQL: MySQL 用多张表 + 外键、JOIN 来模拟关系;关联查询需要大量表连接,深度查询性能会断崖下跌。图数据库:关系是独立存储在边上面,查询直接沿着边遍历,深度关联几乎不怎么衰减。
二、核心原理:存储模型
1. 图存储两种实现
属性图模型(现在主流,Neo4j 使用) 节点 + 边都可以携带属性,边有类型、有方向。工业界最常用,容易理解。
RDF 三元组模型:主语-谓词-宾语,多用于知识图谱、语义网,偏学术,工程落地少。
2. 底层存储结构
图数据库一般分成两类存储:
节点存储区:保存节点 ID、标签、属性;
邻接表(最关键):每个节点,直接保存它相连的所有边、相邻节点。
重点:查询一个节点的所有关联,不需要全表扫描,直接读取邻接列表。 MySQL 没有邻接信息,查多层关系需要多次 JOIN,数据量大时非常慢。
三、查询语言:Cypher(Neo4j 代表)
Cypher 是图查询语言,语法接近自然语言,用来描述图里的节点和关系。示例:找到张三的 2 层好友(好友的好友)
MATCH (p:User{name:"张三"})-[:好友*1..2]-(f:User) RETURN f
翻译成 SQL,需要自连接多次,层级越深 SQL 越臃肿、性能越差。
核心差异:SQL 描述表和字段;Cypher 描述节点和关系。
四、什么时候图数据库很强(适用场景)
✅ 多层深度关系查询场景:
社交网络:好友、粉丝、二度人脉、社群挖掘
知识图谱:百科、医疗知识、风控规则、本体推理
金融风控:团伙欺诈、账号关联、资金转账链路,挖掘团伙
推荐系统:商品、内容之间的关联推荐
网络拓扑、物联网设备链路、供应链溯源、血缘分析(数据仓库表血缘)
五、什么时候不要用图数据库(避坑)
❌ 简单 CRUD、单表查询、大量事务写入、简单报表统计,优先 MySQL。图数据库短板:
简单查询性能不一定优于关系库;
大规模高并发写入场景,不如 MySQL/Redis;
聚合统计、分页、大批量数值计算不是强项;
索引维护成本更高。
一句话选型口诀:查询重点是「实体之间的关联关系」就选图库;查询重点是「大量数据的统计、单条记录增删」就用关系库。
六、核心底层引擎原理:图遍历
图查询本质就是图遍历(深度优先 DFS / 广度优先 BFS)。当你查询 “张三的好友的好友”:
取出张三节点;
读取张三的邻接边,拿到一层好友;
继续沿着好友节点的边,拿到第二层好友;全程顺着边链式遍历,不需要跨表 JOIN。
关系数据库做同样需求:多层 JOIN,每一层都要扫描、关联,层数越多,开销指数上涨。
七、主流图数据库产品
Neo4j:最流行,属性图,Cypher,社区版 + 企业版,入门首选
NebulaGraph:国内开源分布式图数据库,字节开源,适合超大图、分布式
JanusGraph:分布式,可对接 Cassandra/HBase 做存储
TigerGraph:企业商用大图,风控场景常用
八、常见误区澄清
❌ 误区 1:图数据库可以替代 MySQL ✅ 不能,它是互补,不是替换。业务主数据依然放 MySQL;复杂关联查询放到图库。
❌ 误区 2:图数据库天然速度快,什么查询都快 ✅ 只在关联遍历场景有优势;纯数值筛选、大批量统计,性能一般。
❌ 误区 3:图数据库 = 知识图谱 ✅ 知识图谱是业务模型;图数据库是存储引擎。知识图谱可以存在图库,图库也可以存社交、风控链路,不限于知识图谱。
九、总结
图数据库的本质:把实体和实体关系分开存储,通过邻接表快速沿着关系做图遍历。关系数据库靠 JOIN 模拟关系,多层关联性能爆炸;图数据库天生擅长挖掘深度关联、网状数据。核心记忆点:表适合存「事物本身」;图适合存「事物之间的连接」。
-
 【深入浅出】必看图数据库,一文讲透核心原理
一句话概括:图数据库不是存表格,而是存储「实体(节点 Node)+ 实体之间的关系(边 Edge)」,专门用来高效处理复杂关联查询,关系越多、关联越深,对比 MySQL 这类关系型数据库优势越明显。一、基础概念:节点、边、...
-
 全面数据库安装教程:数据库高手进阶之路
数据库安装不是“点下一步”这么简单。真正的高手,会把安装当成部署、安全、性能、可维护性四件事一起完成。下面以 MySQL 8.4 LTS / 8.0 LTS 和 PostgreSQL 16/17 为主线,覆盖 Windows、Linux、Docker 三大场景。一、安装前先选对数...
-
 【干货】数据库设计优化技巧,性能提升10倍
一、表结构设计:从源头减少性能隐患选对数据类型是成本最低、收益最高的优化。能用 TINYINT 就别用 INT,能用 VARCHAR(50) 就别用 VARCHAR(255),日期字段用 DATE/DATETIME 而非字符串存储。字段越短,索引越小,I/O 越少。主键优先用自增整数,避免 UUID 或长字符串做主键。...
-
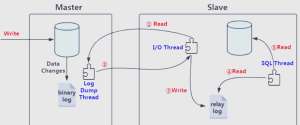 【干货】主从复制优化技巧,性能提升10倍
主从复制是后端开发中最基础的高可用架构方案,无论是面试还是实际项目搭建,核心原理都是相通的。我按 MySQL(关系型代表) 和 Redis(缓存代表) 两大主流中间件,为你整理了一份从原理到配置再到避坑的完整攻略。一、 核心原理速查:为什么能实现数据同步?主从...
-
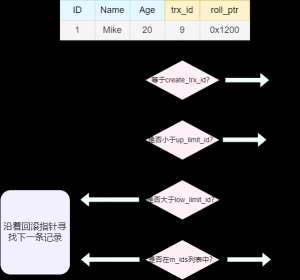 2026年高级MVCC最新趋势与技术选型
既然您提到了“高级”,说明您已经对 MVCC(多版本并发控制)的基础概念(如隐藏字段、Undo Log、Read View)有了基本了解。在高级阶段,我们需要深入探讨 MVCC 的底层架构差异、与锁机制的协同、以及极端场景下的性能瓶颈。以下为您梳理的 MVCC 高级核心知识图谱:一、...
-
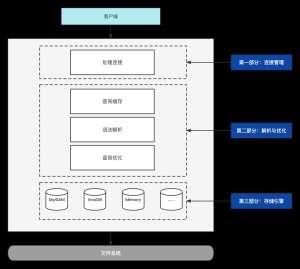 一文搞懂数据库优化方案,面试和工作都用得到
数据库优化是一个系统性工程,通常遵循“先定位瓶颈,再针对性优化”的原则。结合你平时关注的软件开发技术栈,这里为你梳理了一套从 SQL 到架构的实战优化方案,可以直接落地到项目中:第一步:精准定位瓶颈在动手优化前,必须先通过数据找到真正的性能...