【干货】主从复制优化技巧,性能提升10倍
主从复制是后端开发中最基础的高可用架构方案,无论是面试还是实际项目搭建,核心原理都是相通的。我按 MySQL(关系型代表) 和 Redis(缓存代表) 两大主流中间件,为你整理了一份从原理到配置再到避坑的完整攻略。
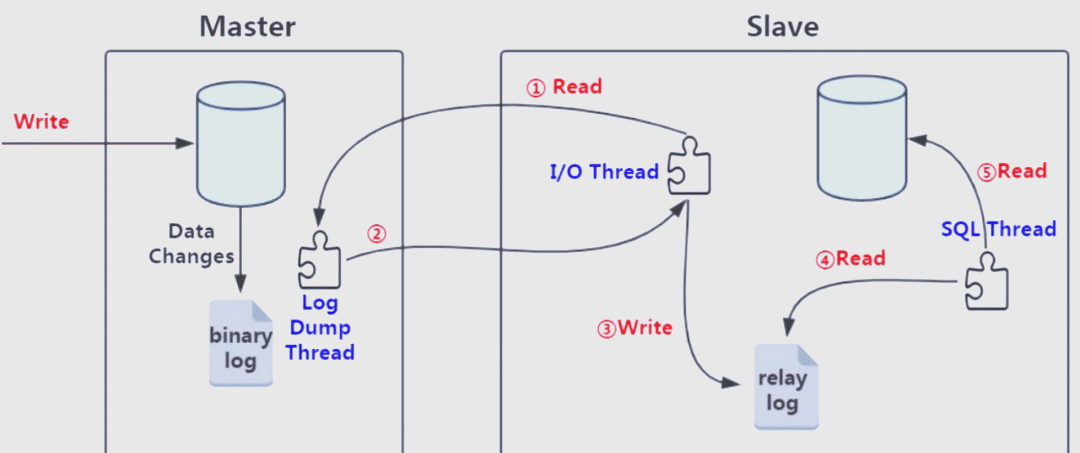
一、 核心原理速查:为什么能实现数据同步?
主从复制的本质是 “日志复制 + 日志回放”,数据单向从主节点流向从节点。
1. MySQL 主从复制(基于 Binlog)
MySQL 8.0+ 官方已将 Master/Slave 改称为 Source/Replica,但底层逻辑不变。核心依赖 3个线程 + 2类日志:
表格
下载为表格
导出为图片
组件作用
主库 Binlog Dump 线程读取主库 Binlog 事件,发送给从库
从库 I/O 线程连接主库,拉取 Binlog 并写入本地中继日志(Relay Log)
从库 SQL 线程读取 Relay Log,在从库本地重放执行,实现数据一致
Binlog(二进制日志)主库的数据变更事件记录,是同步的唯一可信来源
Relay Log(中继日志)从库的临时日志,解耦日志接收与执行
同步流程:
主库写操作 → 记录到 Binlog → 从库 I/O 线程拉取 → 写入 Relay Log → 从库 SQL 线程重放 → 数据同步完成
2. Redis 主从复制(基于 PSYNC)
Redis 复制分为 连接建立、数据同步、命令传播 三个阶段,核心依赖 PSYNC 命令:
全量复制:首次连接或断线后偏移量超出积压缓冲区时触发。主库执行 BGSAVE 生成 RDB 快照发送给从库,从库清空旧数据加载 RDB,主库再补发缓冲区内的增量命令。
部分复制:断线重连且偏移量仍在复制积压缓冲区(默认 1MB 环形队列)内时触发。主库仅补发缺失的增量命令,避免全量同步的高开销。
命令传播:同步完成后,主库异步将写命令实时推送给从库,保持最终一致性。
二、 同步模式对比:异步、半同步、全同步怎么选?
表格
下载为表格
导出为图片
模式机制优点缺点适用场景
异步复制(默认)主库写完 Binlog 立即返回,不等待从库确认性能最优,延迟最低主库宕机可能丢失未同步数据读多写少、对一致性要求不高的场景(如电商详情页)
半同步复制主库写完 Binlog 后,等待至少一个从库确认接收再返回平衡性能与一致性,降低数据丢失风险增加少量网络延迟核心业务(如订单系统、金融业务)
全同步复制主库等待所有从库执行完才返回数据强一致,无丢失风险性能极差,延迟高强一致性要求的分布式系统(需 Galera Cluster 等第三方工具)
关键建议:生产环境推荐使用 GTID 模式 + ROW 格式 Binlog + 半同步复制。GTID 通过全局唯一事务 ID 自动定位同步位置,大幅简化故障切换运维;ROW 格式记录实际数据变更,避免非确定性 SQL 导致的主从不一致。
三、 MySQL 主从配置实战(2026 标准版)
以下以 MySQL 8.4+ GTID 模式为例,传统位点模式仅需将 CHANGE REPLICATION SOURCE TO 替换为 CHANGE MASTER TO 并指定 MASTER_LOG_FILE 和 MASTER_LOG_POS。
步骤 1:配置主库(Master)
修改 my.cnf:
ini
编辑
1[mysqld]
2server-id = 1 # 唯一标识,主从不可重复
3log-bin = mysql-bin # 开启 Binlog
4binlog_format = ROW # 推荐 ROW 格式
5sync_binlog = 1 # 每次事务提交同步 Binlog 到磁盘,防崩溃丢失
6gtid_mode = ON # 开启 GTID
7enforce_gtid_consistency = ON # 强制 GTID 一致性
重启 MySQL 后,创建复制用户并授权:
sql
编辑
1CREATE USER 'repl_user'@'%' IDENTIFIED BY 'your_password';
2GRANT REPLICATION SLAVE ON *.* TO 'repl_user'@'%';
3FLUSH PRIVILEGES;
步骤 2:配置从库(Slave)
修改 my.cnf:
ini
编辑
1[mysqld]
2server-id = 2 # 与主库不同的唯一 ID
3relay-log = mysql-relay-bin # 开启中继日志
4gtid_mode = ON
5enforce_gtid_consistency = ON
6read_only = ON # 防止从库误写
重启后,执行以下命令建立主从关系:
sql
编辑
1CHANGE REPLICATION SOURCE TO
2 SOURCE_HOST = '192.168.1.10',
3 SOURCE_PORT = 3306,
4 SOURCE_USER = 'repl_user',
5 SOURCE_PASSWORD = 'your_password',
6 SOURCE_AUTO_POSITION = 1; # GTID 模式自动定位
7START REPLICA;
步骤 3:验证同步状态
sql
编辑
1SHOW REPLICA STATUSG
确认以下字段均为正常状态:
Replica_IO_Running: Yes(I/O 线程正常)
Replica_SQL_Running: Yes(SQL 线程正常)
Seconds_Behind_Source: 0(无复制延迟)
四、 Redis 主从配置实战
Redis 5.0+ 统一使用 replicaof 替代 slaveof。
方式 1:配置文件方式
在从库 redis.conf 中添加:
ini
编辑
1replicaof 192.168.1.10 6379 # 指定主库 IP 和端口
2masterauth your_password # 若主库设密码,从库需配置认证
3replica-read-only yes # 从库只读(生产环境必须开启)
4repl-backlog-size 256mb # 增大积压缓冲区,减少断线重连全量同步
方式 2:运行时动态配置
bash
编辑
1# 在从库执行
2REPLICAOF 192.168.1.10 6379
3
4# 停止复制(从库晋升为主库,保留现有数据)
5REPLICAOF NO ONE
验证同步状态
bash
编辑
1INFO replication
关注 role、connected_slaves、master_link_status、master_repl_offset 等字段。
五、 高频踩坑点与优化建议
MySQL 避坑
server-id 冲突:主从 server-id 必须唯一,否则复制直接失败。
大事务导致延迟:从库 SQL 线程单线程重放,大事务会阻塞后续同步。MySQL 5.7+ 可开启多线程并行复制(slave_parallel_type = LOGICAL_CLOCK,slave_parallel_workers = 4~8)。
主从数据不一致:严禁在从库直接执行写操作;定期使用 pt-table-checksum 校验数据一致性。
Binlog 清理策略:设置 expire_logs_days = 7,避免 Binlog 占满磁盘。
Redis 避坑
全量复制风暴:多个从库同时首次连接会触发主库多次 BGSAVE,消耗大量 CPU 和内存。建议 stagger 启动从库,或开启无盘复制(repl-diskless-sync yes)。
大 Key 阻塞:主库写入大 Key 会导致从库加载时长时间阻塞,建议避免单 Value 超过 10KB 的 Key。
默认异步丢数据:Redis 默认异步复制,主库宕机可能丢失数据。重要场景可使用 WAIT命令实现有限同步确认。
复制积压缓冲区过小:默认 1MB 极易导致断线重连触发全量复制,建议根据写入量调至 256MB~512MB。
六、 架构拓扑选型
表格
下载为表格
导出为图片
拓扑结构适用场景
一主一从Master → Slave基础容灾、数据备份
一主多从Master → Slave1/2/3高并发读、读写分离
级联复制Master → Slave1 → Slave2减轻主库压力,从库分担同步负载
环形复制(需 GTID)A → B → C → A多地多活、双向同步(需防循环复制)
-
 【干货】主从复制优化技巧,性能提升10倍
主从复制是后端开发中最基础的高可用架构方案,无论是面试还是实际项目搭建,核心原理都是相通的。我按 MySQL(关系型代表) 和 Redis(缓存代表) 两大主流中间件,为你整理了一份从原理到配置再到避坑的完整攻略。一、 核心原理速查:为什么能实现数据同步?主从...
-
 2026年高级MVCC最新趋势与技术选型
既然您提到了“高级”,说明您已经对 MVCC(多版本并发控制)的基础概念(如隐藏字段、Undo Log、Read View)有了基本了解。在高级阶段,我们需要深入探讨 MVCC 的底层架构差异、与锁机制的协同、以及极端场景下的性能瓶颈。以下为您梳理的 MVCC 高级核心知识图谱:一、...
-
 一文搞懂数据库优化方案,面试和工作都用得到
数据库优化是一个系统性工程,通常遵循“先定位瓶颈,再针对性优化”的原则。结合你平时关注的软件开发技术栈,这里为你梳理了一套从 SQL 到架构的实战优化方案,可以直接落地到项目中:第一步:精准定位瓶颈在动手优化前,必须先通过数据找到真正的性能...
-
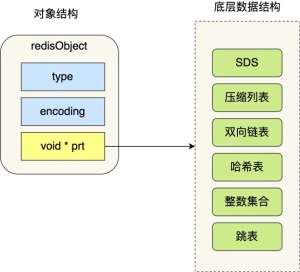 Redis数据类型常见问题排查手册
Redis 早已超越了简单的 Key-Value 缓存,其核心竞争力在于提供了一套丰富且原生支持的数据结构。结合你平时对软件开发技术的关注,以下为你梳理了 Redis 的核心数据类型及其在工程化落地中的选型逻辑:核心基础数据类型(五大金刚)这五种类型覆盖了 90% 以上的常规...
-
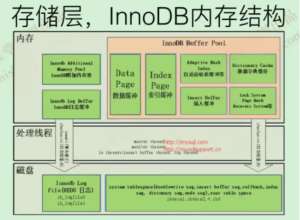 InnoDB手册避坑指南:生产环境血泪教训
文库中暂时没有收录 InnoDB 手册的文档资源,但通过网页搜索为你找到了几个高质量的获取渠道:InnoDB 中文参考手册这是一份专门针对 InnoDB 存储引擎的中文参考手册(CHM 格式),系统性地涵盖了 InnoDB 的全部关键机制与内部原理,包括:事务处理:ACID 四大特性的完整...
-
 2026年HikariCP最佳实践最新趋势与技术选型
HikariCP 是目前 Java 生态中性能最高的数据库连接池,也是 Spring Boot 2.x/3.x 的默认选择。但在生产环境中,直接使用默认参数往往会导致连接耗尽、接口超时甚至服务雪崩。结合最新的线上故障复盘经验,为你梳理了 HikariCP 的核心最佳实践与生产级配置方案:生产环境...