反范式指南避坑指南:生产环境血泪教训
反范式是指在数据库设计中,有意地引入数据冗余,以牺牲部分数据一致性和存储空间为代价,换取查询性能提升和查询逻辑简化的设计策略。

简单来说:范式是"消除冗余",反范式是"用空间换时间"。
核心原则:先满足 3NF,再根据性能需求适度反范式。 就像盖房子,先按标准图纸打好地基(3NF),再根据实际使用需求做装修优化(反范式)。
为什么需要反范式?
严格的范式化设计虽然能保证数据一致性,但在实际高并发、大数据量场景下会暴露明显问题:
JOIN 开销巨大: 简单查询需要关联 5+ 张表,性能急剧下降
查询语句复杂: 深层嵌套子查询频繁出现,开发和维护成本高
分布式环境困难: 分库分表后,跨库 JOIN 成本极高
实测数据(100万订单 + 10万用户):
表格
下载为表格
导出为图片
方案查询 QPS写入耗时存储空间
规范化(JOIN)8005ms1.2 GB
反范式(冗余)3,5008ms1.5 GB
反范式 + 缓存15,00010ms1.5 GB + Redis
结论:读密集场景下,反范式可提升 4 倍以上查询性能,代价是约 25% 的额外存储和更复杂的写入逻辑。
常用反范式技术手段
冗余字段(最常用)
在表中直接存储关联表的常用字段,避免 JOIN。
sql
编辑
1-- 订单表冗余用户信息
2CREATE TABLE orders (
3 order_id BIGINT PRIMARY KEY,
4 user_id INT,
5 username VARCHAR(100), -- 冗余字段
6 user_level VARCHAR(20), -- 冗余字段
7 total_amount DECIMAL(10,2),
8 created_at TIMESTAMP
9);
预计算/汇总表
将聚合计算结果提前存储,避免实时 COUNT/SUM。
sql
编辑
1-- 商品销量汇总表(定时更新)
2CREATE TABLE product_sales_summary (
3 product_id BIGINT PRIMARY KEY,
4 total_sales BIGINT,
5 total_revenue DECIMAL(12,2),
6 last_updated TIMESTAMP
7);
合并表
将频繁一起查询的 1:1 或 1:N 关系的表合并为一张大表。
缓存层
通过 Redis 等缓存热点数据,作为反范式的替代或补充方案。
适用场景判断
适合反范式的场景
读多写少: 报表系统、日志分析平台,数据写入后极少改动
高频多表关联: 订单详情页需要频繁 JOIN 用户表、商品表、地址表
分布式系统: 分库分表后跨库查询困难,提前冗余常用字段
统计类查询: 需要频繁 COUNT/SUM 的场景,用冗余字段替代实时计算
哪些字段适合冗余?
名称类字段: category_name、product_brand(极少改名)
统计类字段: article.comment_count(比实时 COUNT 快得多)
状态描述: order_status_text(避免反复查字典表)
快照类字段: 订单创建时的用户信息快照
不适合反范式的场景
银行转账记录: 金额、状态必须强一致,不容许冗余字段滞后
高频更新字段: 如用户余额、库存数量,极易出现一致性问题
决策框架
文本
编辑
1开始 → 数据模型设计
2 ↓
3 主要操作类型?
4 ├─ 写入为主 → 优先规范化(3NF)
5 │ ↓
6 │ 索引优化是否足够?
7 │ ├─ 是 → 完成
8 │ └─ 否 → 选择性反范式
9 │
10 └─ 读取为主 → 是否有强一致性要求?
11 ├─ 是 → 规范化 + 缓存层
12 └─ 否 → 是否允许最终一致性?
13 ├─ 是 → 反范式 + 异步同步
14 └─ 否 → 规范化 + 读写分离
避坑指南
一致性维护机制
冗余字段必须有配套的同步策略,常见方案:
应用层维护(推荐): 在事务中完成,如插入订单时先查用户表拿到 name,再一并写入 orders 表
触发器: 逻辑集中但调试困难,可能影响写入性能
消息队列/定时任务: 适合允许最终一致性的场景
索引策略要跟进
冗余字段一旦参与查询条件或排序,必须建立对应索引:
sql
编辑
1-- 冗余了 user_name 且常用于筛选,建议建复合索引
2INDEX idx_user_created (user_name, created_at)
渐进式策略(核心原则)
先规范化: 从 3NF 开始,保证数据一致性
定位瓶颈: 通过慢查询日志找出热点 SQL
精准反范式: 只对瓶颈字段进行冗余,不要全盘反范式
同步机制: 建立数据同步保障(触发器/消息队列/定时任务)
监控回滚: 保留规范化视图,必要时可回退
核心总结
表格
下载为表格
导出为图片
维度范式反范式
目标消除冗余,保证一致性引入冗余,提升性能
代价查询慢(多表JOIN)写入复杂,一致性风险
适用写多读少、强一致性场景读多写少、性能敏感场景
原则默认选择有证据才使用
-
 WAL合集详解:从理论到生产环境实践
### WAL合集详解:从理论到生产环境实践在现代数据库系统中,数据的一致性与持久性是衡量其可靠性的核心指标。无论是金融交易的转账记录,还是电商平台的订单状态,任何数据的丢失或损坏都可能导致灾难性的后果。Write-Ahead Logging(预写日志,简称WAL)正是保障这...
-
 MyCat教程:数据库高手进阶之路
### MyCat教程:数据库高手进阶之路在大数据与高并发并行的互联网时代,传统的单机数据库往往成为系统架构中最大的瓶颈。当数据量突破千万级,当QPS(每秒查询率)直线上升,分库分表便成了架构师无法回避的课题。而MyCat,作为基于Java开发的开源数据库中间件,...
-
 表锁选择最佳实践:大厂DBA都在用
#### 表锁选择最佳实践:大厂DBA都在用在数据库的高并发世界里,锁机制是保障数据一致性的最后一道防线,也是性能优化的“双刃剑”。对于许多初入行的开发者而言,表锁往往被视为性能杀手,唯恐避之不及。然而,在大厂的DBA(数据库管理员)眼中,表锁并非洪...
-
 PostgreSQL监控教程常见问题排查手册
#### PostgreSQL监控教程与常见问题排查手册在数据库运维的世界里,PostgreSQL以其强大的功能和稳定性著称,但“慢”往往是悬在开发者头顶的达摩克利斯之剑。很多团队在遇到性能瓶颈时,第一反应往往是盲目增加硬件配置,却忽略了数据库内部的运行指标。实际上,...
-
 2026年Neon备忘单最新趋势与技术选型
### 2026年Neon备忘单:最新趋势与技术选型在2026年的全栈开发版图中,Neon已经不再仅仅是一个“无服务器PostgreSQL”选项,而是演变成了现代数据架构的基石。随着AI原生应用的爆发式增长和边缘计算的普及,开发者对数据库的期望早已超越了简单的CRUD(增删改查)。今...
-
 索引失效常见问题排查手册
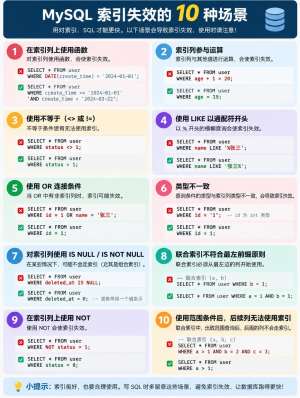
### 索引失效常见问题排查手册在数据库性能优化的浩瀚工程中,索引失效往往是导致系统响应迟缓、CPU飙升的“头号嫌疑人”。索引本应是数据的高速公路,但在特定场景下,它却会退化为羊肠小道,甚至迫使数据库进行全表扫描。本手册旨在系统化梳理索引失效的...