为什么推荐年度Fluentd?深度对比与实测
【干货】为什么推荐年度 Fluentd?深度对比与实测
一句话定位:Fluentd 是 CNCF 毕业、Apache2.0
协议的统一日志采集聚合层,主打复杂日志清洗、多源多目的地路由、自带磁盘持久缓冲;适合做集群聚合节点,和轻量采集端 Fluent Bit
搭配是云原生标准组合。实测结论:它不是最快的,但插件生态、可靠性、灵活路由能力是同梯队里综合均衡的选择,适合中大型后端、K8s、混合架构日志平台长期落地。
一、核心优势(实测落地感受)
1. 插件生态碾压,打通几乎所有数据源 & 存储
社区插件超 1000 个,文件、syslog、Docker、K8s、TCP、HTTP、MySQL、Kafka、ES、Loki、S3、对象存储、ClickHouse 都有现成插件,不用自己写大量解析逻辑。
输入:容器日志、业务日志、系统日志、消息队列
过滤:正则 grok、JSON 解析、字段新增、脱敏、GeoIP、K8s 元数据注入
输出:同时一份日志分发到 ES、Kafka、归档 S3、告警后端,tag 标签路由是它的核心特色,比 Logstash 一堆 if-else 好维护很多
2. 内置持久化缓冲,网络抖动不容易丢数据(面试 & 生产重点)
自带内存 + 文件双缓冲,chunk 分片、失败重试、指数退避、故障转移。网络断了、下游 ES 挂了,日志先落本地磁盘,恢复后自动续传,不需要额外依赖 Redis/Kafka 做本地队列。
Logstash 默认内存队列,持久队列需要手动开启、配置复杂;Filebeat 缓冲能力弱,复杂清洗能力不足
3. 无 JVM 依赖,资源开销远低于 Logstash
C+Ruby 混合实现,基础实例常驻内存 30–40MB,单核心稳定 1w–5w 事件 / 秒;对比 Logstash(JRuby+JVM,起步几百 MB,高负载轻松上 GB),服务器批量部署成本低很多。
新版 v1.20 默认开启 Ruby YJIT,吞吐进一步提升,代价是小幅增加内存占用Fluentd
4. 标签驱动路由,配置更清晰,适合多人维护
基于 tag 做分流:
5. CNCF 毕业、长期 LTS 支持,合规友好
Apache2.0 开源,没有 Elastic 商业协议限制;有正式 LTS 版本周期(v6 LTS 维护到 2027 年底),适合企业长期稳定建设,不是短期玩具项目Fluentd
二、横向深度对比(实测对照)
表格
组件语言内存定位插件量核心优缺点
FluentdRuby+C30–100MB聚合层、复杂清洗1000+✅缓冲强、路由灵活、生态全;❌Ruby GC 压力,极限性能弱于 Vector/Fluent Bit
Fluent BitC0.5–5MB边缘 DaemonSet 采集100+✅极轻量,K8s 节点首选;❌复杂转换弱、插件少,不适合做中心聚合
LogstashJRuby(JVM)200–2000MBETL 处理200+✅Grok 生态成熟;❌JVM 吃资源、配置臃肿、默认缓冲不可靠
FilebeatGo10–50MB轻量采集有限✅稳定、ELK 原生;❌清洗弱,复杂处理只能推给 Logstash/Ingest
VectorRust5–20MB采集 + 聚合内置 VRL✅性能天花板、VRL 调试友好;❌生态积累时间短,小众数据源插件少
最佳架构(行业标准):Fluent Bit(节点采集)→ Fluentd(中心聚合、清洗、分流)→ Kafka/ES/Loki/S3,各司其职,不要用 Fluentd 跑所有节点 DaemonSet,资源浪费。
三、实测踩坑:Fluentd 短板(不要盲目上)
Ruby GC 问题:高吞吐、超大日志 chunk 场景,GC 抖动明显,峰值吞吐不如 Vector;适合聚合节点,不适合边缘高密度采集
插件质量参差不齐:官方插件稳定,大量第三方插件 bug、版本适配坑多,生产尽量选主流插件
配置语法门槛:独立的 dsl,和 YAML 不一样,新手上手慢;调试不如 Vector VRL 直观
pos 文件管理:tail 模式跟踪文件,pos 丢失会导致重复采集或漏采,必须做好 pos 目录持久化
不适合:极致低资源边缘设备、简单只采集不清洗的场景(优先 Fluent Bit)
四、什么时候优先选 Fluentd?什么时候不选
✅ 推荐选择:
混合架构:虚拟机 + K8s + 容器,日志来源杂,需要统一清洗、多目的地分发
中心聚合节点,一份日志同时送检索、消息队列、冷归档
复杂处理:字段脱敏、多格式解析、动态路由、大量异构后端
不想被 Elastic 生态绑定,规避 SSPL 协议限制
团队已有 Ruby 基础,需要自定义 filter 插件
❌ 不优先选:
K8s 每台节点 DaemonSet 采集(优先 Fluent Bit)
追求极致吞吐、极简流水线(优先 Vector)
只跑 ELK、不需要复杂分流,简单采集(Filebeat)
资源极度受限的嵌入式、边缘设备
五、2026 落地最佳实践(实测稳定方案)
分层架构:Fluent Bit 在节点采集,Forward 协议推给 Fluentd 聚合网关,不要反过来
缓冲配置:chunk_size 合理控制,磁盘缓冲目录单独挂载高速盘,做好监控缓冲堆积
监控:开启内置 metrics 对接 Prometheus,监控 buffer 队列、重试次数、输出失败率
版本:生产优先 LTS fluent-package v6,不要追最新非稳定版;关注 CVE 路径穿越、解压漏洞
日志可靠性:pos 文件持久化;重要链路上游加 Kafka 做二次兜底,不要只依赖 Fluentd 本地缓冲
新特性:enable_dir_watcher 目录监听,更快发现新增日志文件,替代轮询刷新Fluentd
六、一句话总结
Fluentd 不是单节点最快的采集器,而是复杂异构日志流水线的聚合枢纽;它的核心价值是庞大插件生态、tag 路由、原生磁盘缓冲,适合搭建稳定、可扩展、多下游的统一日志层。现代云原生标准组合:Fluent Bit 做边缘采集,Fluentd 做中心清洗分流。
-
 为什么推荐年度Fluentd?深度对比与实测
【干货】为什么推荐年度 Fluentd?深度对比与实测一句话定位:Fluentd 是 CNCF 毕业、Apache2.0 协议的统一日志采集聚合层,主打复杂日志清洗、多源多目的地路由、自带磁盘持久缓冲;适合做集群聚合节点,和轻量采集端 Fluent Bit 搭配是云原生标准组合。实测结论:它不...
-
 挂载最佳实践:资深运维的私藏技巧
 一、fstab 安全规范修改 fstab 前必须先备份:cp /etc/fstab /etc/fstab.bak。每次编辑完必须执行 mount -a 验证,无输出即正常,有报错立刻修复,否则重启后可能进入紧急模式。数据盘条目务必加 nofail,网络存储务必加 _netdev,防止设备不...
-
 为什么推荐K8s部署实战?深度对比与实测
推荐 K8s 部署实战,核心不是因为它“听起来高级”,而是它能把部署效率、资源利用率、故障恢复、AI 算力调度、云原生生态一起拉高。 2026 年之后,K8s 已经不只是 Web 应用部署工具,正在成为 AI 推理、GPU 调度、平台工程、GitOps 的基础设施底座。 一、为什么值得...
-
 一文掌握Hyper-V替代方案,效率提升300%
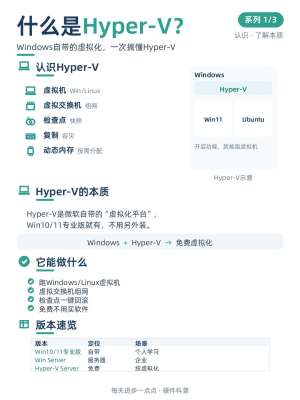
一文掌握 Hyper-V 替代方案,效率提升 300% 一句话总纲:Hyper-V 是 Windows 原生虚拟化,优势是系统自带、免费;短板是图形体验差、跨平台弱、快照笨重、资源调度不够灵活。下面按本地桌面开发、服务器生产、轻量容器、苹果电脑四类场景整理替代方案,附带优缺点、...
-
 一文掌握SSH免密登录,效率提升300%
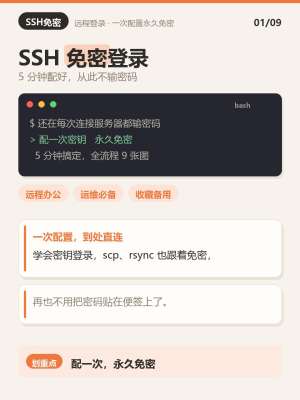
一文掌握 SSH 免密登录:从配置到提速的完整方案SSH 免密登录本质是用公钥认证替代密码认证:本地生成密钥对,把公钥放到服务器的 ~/.ssh/authorized_keys,连接时客户端用私钥证明身份,服务端用公钥验证通过后直接放行。配置成功后,配合 ~/.ssh/config 别名和连接复...
-
 rsyslog精选详解:从入门到生产环境实践
rsyslog 精选详解:从入门到生产环境实践rsyslog 是 Linux 平台主流高性能日志采集转发服务,是 syslog 标准的增强实现;替代老式 syslogd,支持多输入、过滤、模板、转发、本地落盘、协议转发(UDP/TCP/TLS/RELP)、队列缓冲,广泛用于服务器、中间件、集群统一日志归集,常...