索引错误解决常见问题排查手册
#### 索引错误解决常见问题排查手册
在数据库性能优化的战场上,索引失效往往是最令人头疼的“隐形杀手”。你可能明明在表上建了索引,查询速度却依然慢如蜗牛,甚至直接退化成全表扫描。这种“建而不用”的现象,通常不是数据库的Bug,而是我们触碰了优化器的底层规则红线。为了帮助大家快速定位并解决这类顽疾,特整理这份排查手册,助你扫除性能障碍。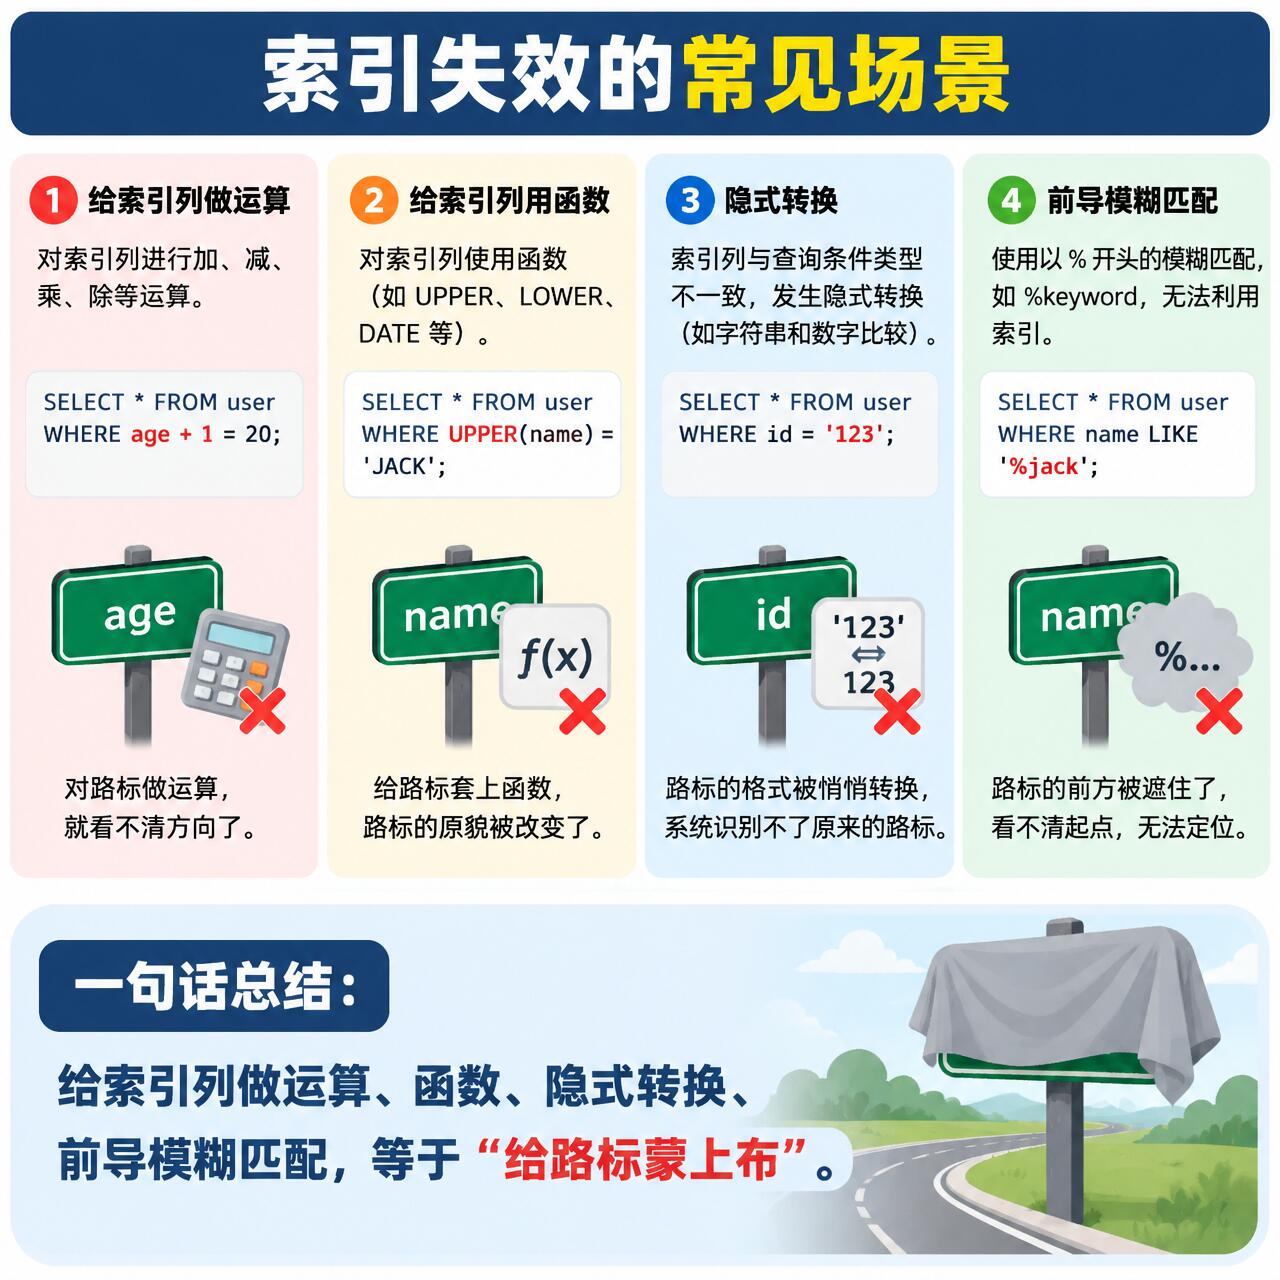
#### 第一阶段:诊断——看清真相
在动手修改之前,必须先通过执行计划看清数据库到底在做什么。这是排查索引问题的核心工具。
在MySQL中,使用`EXPLAIN`命令是基本功。重点关注输出结果中的`type`列和`key`列。如果`type`显示为`ALL`,意味着发生了全表扫描,索引彻底失效;如果`key`列为`NULL`,说明优化器没有找到可用的索引。反之,若`type`为`ref`或`range`,且`key`显示了你预期的索引名,则说明索引正在正常工作。在PostgreSQL中,则需关注执行计划中是出现了`Seq Scan`(全表扫描)还是`Index Scan`(索引扫描)。
#### 第二阶段:排查——十大“失效”陷阱
一旦确认索引失效,通常是因为你的SQL语句触犯了以下禁忌。请对照排查:
- **数据类型不匹配(隐式转换)**
这是新手最容易犯的错误。当查询条件的字段类型与传入值类型不一致时,数据库会发生隐式类型转换,导致索引失效。例如,`user_id`字段是字符串类型(VARCHAR),但查询时写成了`WHERE user_id = 100`(数字)。数据库会尝试将列数据转为数字进行比较,这直接绕过了索引。
**解决方案**:保持类型严格一致,字符串必须加引号,即`WHERE user_id = '100'`。
- **索引列上“动刀”(函数与运算)**
在索引列上使用函数或进行数学运算,是索引的“死穴”。例如`WHERE DATE(created_at) = '2023-01-01'`,数据库必须对每一行数据计算日期后才能比较,无法利用树结构。
**解决方案**:将运算移到等号右边,改为范围查询,如`WHERE created_at >= '2023-01-01 00:00:00' AND created_at < '2023-01-02 00:00:00'`。
- **模糊查询的前导通配符**
`LIKE`查询中,如果通配符`%`放在了最左边(如`'%apple'`),B+树索引将无从下手,因为树的匹配是从左向右的。
**解决方案**:尽量避免左模糊。如果必须使用,考虑引入Elasticsearch等全文检索引擎,或者使用数据库的全文索引(Fulltext Index)。
- **违反“最左前缀”原则**
对于联合索引(如`(city, age)`),必须遵循从左到右的顺序。如果查询条件直接跳过`city`只用`age`(`WHERE age > 30`),索引将失效。
**解决方案**:调整查询条件顺序,或者根据业务需求重新设计联合索引的列顺序。
- **OR条件的“连坐”效应**
在`WHERE user_id = 100 OR status = 'pending'`中,如果`status`字段没有索引,数据库为了保证结果正确,可能会放弃使用`user_id`的索引,转而进行全表扫描。
**解决方案**:确保OR两边的字段都有索引,或者拆分为两个查询使用`UNION ALL`连接。
- **NOT、!=与IS NOT NULL**
虽然现代数据库优化器(如MySQL 5.7+)在某些场景下已经能利用索引处理`!=`,但在数据分布不均或选择性较低时,优化器仍倾向于全表扫描。特别是`IS NOT NULL`,往往会导致索引失效。
**解决方案**:尽量将`IS NOT NULL`替换为具体的值判断(如`WHERE phone > ''`),或重构业务逻辑。
- **统计信息过期**
数据库优化器是基于成本(CBO)做决策的。如果表的统计信息长期未更新,优化器可能误判数据量,从而错误地放弃索引。
**解决方案**:定期执行`ANALYZE TABLE`(MySQL)或`VACUUM ANALYZE`(PostgreSQL)来更新统计信息。
#### 第三阶段:进阶与兜底
如果上述常规手段都无效,可能涉及更深层的原因。例如,当表数据量极小(如少于1000行)时,全表扫描的成本其实低于索引回表,此时优化器选择全表扫描是合理的。此外,字符集不一致(如连接查询时两表字符集不同)也会导致隐式转换从而失效。
在极端情况下,如果确定优化器判断失误,可以使用强制索引提示(如MySQL的`FORCE INDEX`)来强制走索引,但这属于“核武器”,需谨慎使用,以免未来数据量变化后产生反效果。
#### 结语
索引优化没有银弹,核心在于理解数据库的底层逻辑。通过规范SQL编写习惯,避开上述陷阱,绝大多数索引失效问题都能迎刃而解。保持对执行计划的敏感度,是每一位后端开发者的必修课。
-
 索引错误解决常见问题排查手册
#### 索引错误解决常见问题排查手册在数据库性能优化的战场上,索引失效往往是最令人头疼的“隐形杀手”。你可能明明在表上建了索引,查询速度却依然慢如蜗牛,甚至直接退化成全表扫描。这种“建而不用”的现象,通常不是数据库的Bug,而是我们触碰了优化...
-
 【深入浅出】InfluxDB,一文讲透核心原理
#### 【深入浅出】InfluxDB,一文讲透核心原理在万物互联的数字化时代,时间序列数据呈现爆发式增长。从服务器的CPU监控到智能工厂的传感器读数,这些数据都具有时间维度强关联、写入吞吐量极高、聚合查询密集三大特征。面对传统关系型数据库在处理此类场景...
-
 企业级Druid连接池教程:数据库高手进阶之路
#### 企业级Druid连接池教程:数据库高手进阶之路在企业级应用开发中,数据库连接池不仅是性能优化的“第一道防线”,更是系统稳定性的基石。尽管HikariCP以轻量级著称,但阿里巴巴开源的Druid凭借其强大的监控能力和扩展性,依然是国内Java生态中处理复杂业务场...
-
 MGR实战教程:数据库高手进阶之路
### MGR实战教程:数据库高手进阶之路在数据库高可用架构的演进历程中,传统的异步主从复制因其数据一致性风险逐渐难以满足核心业务的需求,而MGR(MySQL Group Replication)作为MySQL官方主推的新一代高可用方案,凭借其基于Paxos协议的强一致性保障和自动故障转移能力...
-
 SQL慢查询怎么排查完全指南:2026年数据库实战
### SQL慢查询怎么排查完全指南:2026年数据库实战在2026年的数据驱动时代,数据库依然是绝大多数业务系统的核心瓶颈。当一条SQL语句从毫秒级劣化到秒级甚至超时,它不仅影响用户体验,更可能引发“雪崩效应”拖垮整个服务。面对慢查询,许多开发者的第一反应...
-
 WAL合集详解:从理论到生产环境实践
### WAL合集详解:从理论到生产环境实践在现代数据库系统中,数据的一致性与持久性是衡量其可靠性的核心指标。无论是金融交易的转账记录,还是电商平台的订单状态,任何数据的丢失或损坏都可能导致灾难性的后果。Write-Ahead Logging(预写日志,简称WAL)正是保障这...