PostgreSQL监控教程常见问题排查手册
#### PostgreSQL监控教程与常见问题排查手册
在数据库运维的世界里,PostgreSQL以其强大的功能和稳定性著称,但“慢”往往是悬在开发者头顶的达摩克利斯之剑。很多团队在遇到性能瓶颈时,第一反应往往是盲目增加硬件配置,却忽略了数据库内部的运行指标。实际上,90%的数据库故障都可以通过规范的监控体系和科学的排查思路提前发现并解决。本手册旨在建立一套从监控指标到故障排查的完整闭环,帮助你从“救火队员”转型为“防火专家”。
#### 建立全方位的监控雷达
监控是排查问题的前提。一个健壮的PostgreSQL监控体系不应只关注CPU和内存,而应深入到数据库内部的“血液循环系统”。
**资源与连接层监控**
这是数据库的生命线。你需要实时监控连接数,确保其未达到`max_connections`的上限。连接数耗尽通常意味着应用端连接池配置不当或存在连接泄漏。同时,关注`work_mem`和`shared_buffers`的使用情况,这两个参数直接影响排序和缓存性能。如果磁盘IOPS持续打满,说明硬件资源已成为瓶颈,此时优化SQL的效果往往不如升级存储。
**缓存与效率指标**
缓存命中率是衡量数据库健康度的核心指标。
- **Buffer Cache命中率**:计算公式为 `sum(blks_hit) / (sum(blks_hit) + sum(blks_read))`。如果该比率低于95%,说明数据库频繁进行物理I/O,需考虑增加`shared_buffers`或优化查询。
- **索引命中率**:通过对比`idx_scan`(索引扫描)与`seq_scan`(全表扫描)的比例来判断。如果一张大表频繁发生全表扫描,说明缺失索引或索引失效。
**脏数据与膨胀监控**
PostgreSQL的MVCC机制会导致死元组(Dead Tuples)的产生。需监控`pg_stat_user_tables`中的`n_dead_tup`字段。如果死元组数量过高且自动清理(AutoVacuum)未及时跟进,会导致表膨胀,严重拖慢查询速度。
#### 慢查询的“七步排查法”
当收到“数据库慢”的报警时,不要慌张,按照以下逻辑链条进行排查:
1. **看计划**:使用`EXPLAIN (ANALYZE, BUFFERS)`分析慢SQL。这是诊断性能的“X光片”,能展示真实的执行时间和行数。
2. **看索引**:检查执行计划中是否出现了`Seq Scan`(全表扫描)。如果是大表,必须创建索引。
3. **看类型**:检查索引类型是否匹配。例如,对JSONB字段查询是否使用了GIN索引。
4. **看字段**:检查查询条件中的字段数据类型是否与表结构一致,避免隐式类型转换导致索引失效。
5. **看数据**:检查数据分布是否倾斜,统计信息(Statistics)是否过期,必要时执行`ANALYZE`。
6. **看分区**:如果单表超过100万行或10GB,考虑是否需要进行表分区。
7. **看归档**:历史数据是否已归档?冷热数据分离是解决海量数据性能问题的终极方案。
#### 常见错误写法与优化方案
在生产环境中,很多性能事故是由糟糕的SQL写法引发的。以下是三个典型的“性能杀手”及其解法:
**全字段查询的陷阱**
- **错误写法**:`SELECT * FROM users WHERE status = 'active';`
- **危害**:传输大量无用数据(如`password_hash`、`metadata`),增加网络带宽消耗和Java应用的内存解析压力。
- **优化**:只查询前端需要的字段,如`SELECT id, username, email FROM users...`。
**模糊查询的代价**
- **错误写法**:`SELECT * FROM products WHERE name LIKE '%手机%';`
- **危害**:前置通配符导致索引完全失效,引发全表扫描。百万级数据表可能耗时数秒,直接打满CPU。
- **优化**:使用全文检索(Full Text Search)配合GIN索引,或者使用Elasticsearch承担复杂的搜索需求。
**应用层的N+1问题**
- **现象**:查看监控发现,一个接口发起了1000次`SELECT`请求。
- **危害**:这是典型的ORM框架使用不当,导致数据库连接被频繁占用,网络延迟被放大1000倍。
- **优化**:在应用层使用`JOIN`或`IN`查询,将多次交互合并为一次。
#### 锁与长事务:隐形的系统杀手
有时候数据库慢,不是因为SQL写得烂,而是因为被“堵”住了。长事务是PostgreSQL性能的头号大敌。
你可以通过以下SQL快速定位运行超过5分钟的活动事务:
```sql
SELECT * FROM pg_stat_activity
WHERE state = 'active'
AND now() - xact_start > '5min'::interval;
```
长事务不仅占用连接,还会阻止Vacuum进程清理死元组,导致表膨胀。严禁在数据库事务中调用外部HTTP API,这是导致长事务的最常见原因。此外,还需警惕锁等待,通过`pg_locks`视图排查是否有DDL操作阻塞了DML操作。
#### 结语
PostgreSQL的调优不是玄学,而是一门基于数据和逻辑的科学。从建立完善的监控指标,到掌握“七步排查法”,再到规避常见的SQL反模式,每一步都是对系统稳定性的加固。记住,最好的优化不是在故障发生时力挽狂澜,而是在故障发生前将其消灭在萌芽状态。
-
 PostgreSQL监控教程常见问题排查手册
#### PostgreSQL监控教程与常见问题排查手册在数据库运维的世界里,PostgreSQL以其强大的功能和稳定性著称,但“慢”往往是悬在开发者头顶的达摩克利斯之剑。很多团队在遇到性能瓶颈时,第一反应往往是盲目增加硬件配置,却忽略了数据库内部的运行指标。实际上,...
-
 2026年Neon备忘单最新趋势与技术选型
### 2026年Neon备忘单:最新趋势与技术选型在2026年的全栈开发版图中,Neon已经不再仅仅是一个“无服务器PostgreSQL”选项,而是演变成了现代数据架构的基石。随着AI原生应用的爆发式增长和边缘计算的普及,开发者对数据库的期望早已超越了简单的CRUD(增删改查)。今...
-
 索引失效常见问题排查手册
### 索引失效常见问题排查手册在数据库性能优化的浩瀚工程中,索引失效往往是导致系统响应迟缓、CPU飙升的“头号嫌疑人”。索引本应是数据的高速公路,但在特定场景下,它却会退化为羊肠小道,甚至迫使数据库进行全表扫描。本手册旨在系统化梳理索引失效的...
-
 MySQL速查表常见问题排查手册
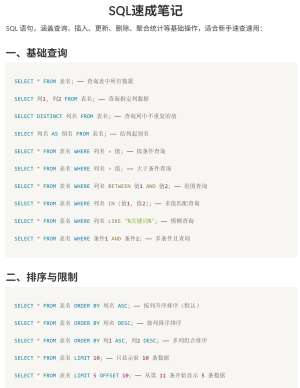
MySQL 速查表・常见问题排查手册一句话主线:按现象定位、先看日志再抓现场,优先区分慢查询、锁问题、连接耗尽、报错、主从同步、索引失效六大类,所有命令适配 MySQL 5.7 / 8.0。提示:生产执行前尽量在测试验证;高危操作(kill、改参数)避开业务高峰。一、基础...
-
 聚簇索引怎么用常见问题排查手册
聚簇索引常见问题排查手册(MySQL InnoDB)前置:InnoDB 只有聚簇索引,聚簇索引就是主键索引,数据行本身就存在主键索引的叶子节点,索引和数据绑定在一起;二级索引叶子节点存的是主键值,不是行地址。适用:后端面试、数据库故障排查、慢 SQL 优化,只讲实战现象...
-
 聚簇索引路线图避坑指南:生产环境血泪教训
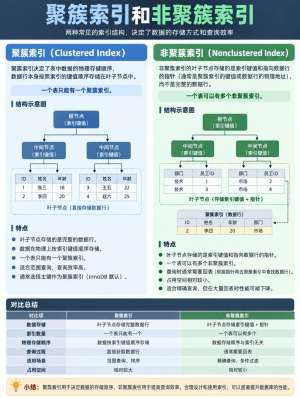
 一、核心认知:聚簇索引决定整张表的物理存储InnoDB 是索引组织表,主键索引的叶子节点就是完整行数据,数据按主键顺序物理排列。5 一张表只有一个聚簇索引,选错主键,所有二级索引跟着遭殃。二、主键选型:最...