【推荐】ELK日志最佳实践,大厂都在用
2026年ELK日志平台最佳实践:从架构到成本的全链路方案
2026年ELK仍然是企业级日志平台的工业级标准,但"最佳实践"已经从单纯部署组件,演进为架构解耦、成本可控、可观测性融合的系统工程。
下面从架构、配置、优化、选型四个维度展开。
一、生产级架构:告别单体ELK,拥抱ELFKK
经典ELK(Elasticsearch + Logstash + Kibana)在日志量小时够用,但一旦日增量超过数十GB,Logstash的JVM资源消耗和单点故障就会暴露。 大厂的主流架构已经演进为ELFKK:
Filebeat → Kafka → Logstash → Elasticsearch → Kibana
Filebeat:Go语言编写,内存占用仅几MB,部署在每台业务服务器上采集日志,负责最原始的日志行读取和简单结构化。
Kafka:作为消息队列缓冲层,削峰填谷。日志洪峰时Kafka暂存数据,下游Logstash/ES故障也不会丢日志,同时支持多消费者(一份日志可同时送ELK、S3、数据仓库)。
Logstash:从Kafka消费数据,做JSON解析、Grok过滤、字段富化,再写入ES。生产环境建议多实例部署,pipeline.workers设为CPU核心数。
Elasticsearch集群:至少3节点,Master与Data角色分离。JVM堆内存设为物理内存50%且不超过32GB,单索引控制在20-50GB。
Kibana:可视化查询入口,生产环境必须通过Nginx反向代理+SSL+Basic Auth/X-Pack Security做访问控制。
二、日志规范:先治理,后存储
混乱的原始日志是ELK效率低下的根源。接入ELK前必须统一日志规范:
强制JSON格式输出:应用层使用Logback/Log4j2等框架的JSON编码器,直接输出结构化日志,避免Logstash用Grok正则解析的CPU开销。
核心字段必须包含:TraceID(全链路追踪)、时间戳、服务名、日志级别、业务标识(如订单ID、用户ID)。
TraceID与APM打通:将日志中的TraceID与SkyWalking/Jaeger等APM系统关联,从Kibana点击即可跳转完整调用链,排障效率提升数倍。
遗留系统渐进式改造:对无法重构的老模块,用AOP切面注入TraceID等字段,实现新旧兼容。
三、存储与索引优化:降本的关键
ES集群成本高昂,优化空间极大:
索引策略:按"服务名 + 时间"创建索引(如order-service-2026.10.24),而非简单按天建大索引。查询时可精准定位,从分钟级降至秒级。
字段映射:TraceID、订单ID等精确匹配字段设为keyword类型,而非默认分词的text类型,避免不必要的索引开销。
冷热分离:通过ILM(Index Lifecycle Management)实现自动生命周期管理——近7天热数据存SSD,7-30天温数据迁移至HDD,30天以上冷数据归档到S3/MinIO对象存储(ES 8.x的Searchable Snapshot特性可保持归档数据仍可查询)。
禁止自动创建索引:action.auto_create_index: false,通过模板预定义mapping,防止脏数据污染集群。
四、从监控到预警:主动发现问题
Kibana告警:基于日志模式设置规则,如"5xx错误率超过阈值""订单创建成功但10分钟未支付"等,主动发现故障。
业务仪表盘:按服务维度建立Dashboard,展示QPS、错误率、P95延迟等核心指标,让日志数据驱动业务决策。
五、2026年选型视野:ELK不是唯一答案
随着日志量增长,ELK的存储成本和运维复杂度成为痛点,2026年出现了多个值得关注的替代/混合方案:
Grafana Loki:放弃全文索引,仅索引标签(Labels),日志正文压缩存对象存储。存储成本比ELK低60%-80%,与Prometheus/Grafana无缝集成,是K8s环境和成本敏感团队的首选。但全文检索和复杂聚合能力弱于ES。
Apache Doris:丰巢等大厂已用Doris替换ELK,在同等硬件下写入快2倍、查询快6倍、存储成本降50%。适合高吞吐写入+SQL分析场景,但全文检索能力不如ES。
ClickHouse:列式存储+智能压缩,聚合查询性能极强,适合日志统计分析场景。
混合架构推荐:大型组织可采用分层策略——基础设施日志走Loki(低成本),安全审计和复杂分析走ELK/OpenSearch(强检索),业务行为日志走ClickHouse/Doris(强聚合)。
六、落地路线图
试点阶段:选一个核心业务系统,完成日志规范制定和ELK基础集群搭建。
推广阶段:引入Kafka缓冲、完善ILM冷热分离、配置告警规则。
赋能阶段:打通APM链路追踪,建立业务分析Dashboard,让日志数据驱动优化决策。
一句话总结:2026年ELK最佳实践的核心是Filebeat轻量采集 + Kafka解耦缓冲 + ES冷热分离 + 日志结构化规范。如果日日志量超过TB级且成本压力大,建议评估Loki或Doris作为替代或混合方案。
-
 【推荐】ELK日志最佳实践,大厂都在用
2026年ELK日志平台最佳实践:从架构到成本的全链路方案2026年ELK仍然是企业级日志平台的工业级标准,但"最佳实践"已经从单纯部署组件,演进为架构解耦、成本可控、可观测性融合的系统工程。 下面从架构、配置、优化、选型四个维度展开。 一、生产级架构:告别...
-
 为什么后端安全这么重要?深度剖析底层原理
核心判断:前端是门面,后端是信任与数据的底盘。前端所有校验、展示、权限都可以被绕过;后端是业务逻辑、核心数据、资金、权限、接口控制唯一可信的防线。前端防 “普通用户误操作”,后端防 “攻击者”。一旦后...
-
 完整负载均衡常见问题及解决方案大全
负载均衡(LB)核心目标:流量分发、故障隔离、会话保持、限流防护、提升吞吐。下面按接入层问题、转发调度问题、会话问题、健康检查问题、性能瓶颈、SSL 相关、四层 / 七层差异、运维与业务异常分类整理,包含现象、根因...
-
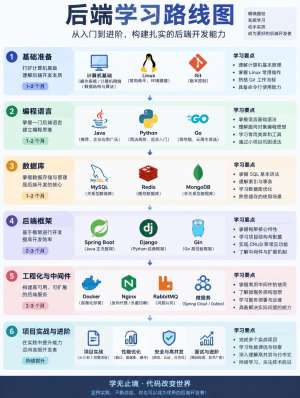 【硬核】Linux后端框架,从原理到落地全解析
Linux后端框架:从原理到落地全解析2026年Linux后端框架已经不再只是“选一个Web框架”的问题,而是语言运行时 + 框架模型 + 并发机制 + 数据库与中间件 + 容器化部署 + 可观测性的系统工程。选型时不要只看热度,要看场景:企业级业务、高并发网关、AI服务、实时...
-
 降级如何实现入门到精通,这份后端学习路线请收好
这里说的降级是系统设计里的服务降级,后端核心高可用能力。本路线从零基础理解概念,到编码落地,再到架构精通,循序渐进。适合后端开发,Java Go Python 等语言都适用。阶段 1 入门阶段 理解基础概念 1 到 3 ...
-
 后端架构框架终极指南:2026后端开发实战
后端架构框架终极指南:2026 实战选型与架构演进2026 年后端开发的核心变化可以概括为三句话:多语言并存已成常态,云原生从"可选"变成"标配",AI 原生能力正在内嵌为架构一等公民。 下面从语言选型、架构模式、核心组件、工程化四个维度展开实战指南。一、语...