问答系统入门教程:专业团队一站式搞定
这是一份 2026 年版问答系统(QA System)入门教程,结合你之前的 Docker 和后端开发背景,我按「原理 → 架构 → 技术选型 → 实战搭建 → 优化」的逻辑来展开,重点聚焦当前主流的 RAG(检索增强生成)架构。
一、 什么是问答系统?
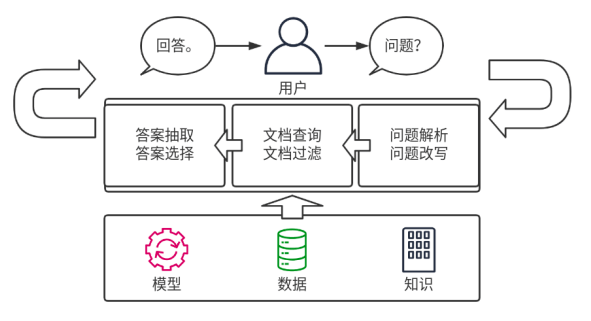
问答系统(Question Answering System)是一种能理解用户自然语言提问,并从知识库中检索或生成精准答案的智能系统。它本质上是信息检索的高级形态,核心目标是让用户用"说话"的方式获取信息,而非传统的关键词搜索。
典型应用场景:
企业智能客服(FAQ 自动应答)
内部知识库问答(研发文档、规章制度查询)
教育辅导(个性化答疑)
医疗/法律咨询(专业领域知识问答)
二、 问答系统的核心架构
一个完整的问答系统通常分为 四层架构:
1. 数据层(Knowledge Layer)
负责知识的存储与管理,是问答系统的"大脑"。
结构化数据:MySQL、Neo4j(知识图谱)
非结构化数据:PDF、Word、Markdown 文档
向量数据库:FAISS、ChromaDB、Milvus(存储文本的向量表示)
2. 算法层(Algorithm Layer)
负责理解问题和检索答案,是系统的"核心引擎"。
NLP 预处理:分词、实体识别、意图分类(spaCy、NLTK、Hugging Face Transformers)
语义理解:BERT、RoBERTa 等预训练模型提取语义特征
检索引擎:BM25 关键词检索 + 向量语义检索(混合检索效果最佳)
3. 服务层(Service Layer)
负责对话管理和 API 封装。
对话管理:维护多轮对话上下文(Redis 存储会话状态)
API 网关:FastAPI / Flask 提供 RESTful 接口
监控告警:Prometheus + Grafana 监控响应时间、召回率
4. 应用层(Application Layer)
面向用户的交互界面。
Web 聊天窗口、移动端 App、语音助手、IM 机器人(钉钉/飞书/微信)
三、 主流技术方案选型
2026 年主流的问答系统技术方案有三种,需根据场景选择:
表格
下载为表格
导出为图片
方案原理优点缺点适用场景
FAQ 问答对预设问答对,关键词/向量匹配直接返回响应快、答案可控、成本低覆盖有限、无法处理复杂问题客服机器人、产品 FAQ
RAG(检索增强生成)文档切片→向量化→检索相关片段→LLM 生成回答灵活、支持动态知识、回答自然成本较高、偶有幻觉知识库查询、文档问答、法规解读
端到端大模型单一模型处理全流程(微调后直接生成)上下文理解强、支持少样本学习算力成本高(约为 RAG 的 15 倍)、微调周期长合同解析、隐含语义理解
推荐:大多数场景采用 混合方案——优先匹配 FAQ 库快速返回,未命中时走 RAG 流程,兼顾效率与灵活性。
四、 RAG 问答系统搭建实战(Python + LangChain)
以下是一个从零搭建 RAG 知识库问答系统的完整流程,基于 Python 技术栈。
步骤 1:环境准备
bash
编辑
1# 创建虚拟环境
2conda create -n qa_system python=3.9
3conda activate qa_system
4
5# 安装核心依赖
6pip install langchain openai chromadb faiss-cpu gradio
步骤 2:数据预处理(文档加载与切片)
python
编辑
1from langchain.document_loaders import PyPDFLoader
2from langchain.text_splitter import RecursiveCharacterTextSplitter
3
4# 加载 PDF 文档
5loader = PyPDFLoader("docs/manual.pdf")
6documents = loader.load()
7
8# 语义分块(推荐 chunk_size=400-800,overlap=50-100)
9text_splitter = RecursiveCharacterTextSplitter(
10 chunk_size=500,
11 chunk_overlap=50
12)
13docs = text_splitter.split_documents(documents)
步骤 3:向量化与知识库构建
python
编辑
1from langchain.embeddings import OpenAIEmbeddings
2from langchain.vectorstores import Chroma
3
4# 使用 OpenAI Embedding 模型(也可替换为本地 BGE-M3)
5embeddings = OpenAIEmbeddings()
6
7# 将文档向量存入 ChromaDB
8vectorstore = Chroma.from_documents(docs, embeddings)
步骤 4:构建 RAG 问答链
python
编辑
1from langchain.chains import RetrievalQA
2from langchain.llms import OpenAI
3
4# 初始化 LLM(temperature=0 保证回答稳定性)
5llm = OpenAI(temperature=0)
6
7# 构建检索增强生成链
8qa_chain = RetrievalQA.from_chain_type(
9 llm=llm,
10 chain_type="stuff",
11 retriever=vectorstore.as_retriever(search_kwargs={"k": 5}) # 返回 Top-5 相关片段
12)
13
14# 测试问答
15response = qa_chain.run("如何重置设备密码?")
16print(response)
步骤 5:快速搭建聊天 UI(Gradio)
python
编辑
1import gradio as gr
2
3def chatbot(question):
4 return qa_chain.run(question)
5
6demo = gr.Interface(fn=chatbot, inputs="text", outputs="text", title="知识库问答助手")
7demo.launch()
步骤 6:容器化部署(Docker)
结合你之前学的 Docker,可将服务打包部署:
dockerfile
编辑
1FROM python:3.9-slim
2WORKDIR /app
3COPY requirements.txt .
4RUN pip install -r requirements.txt
5COPY . .
6EXPOSE 7860
7CMD ["python", "app.py"]
bash
编辑
1docker build -t qa-bot .
2docker run -p 7860:7860 qa-bot
五、 关键技术优化策略
1. 检索效果优化
混合检索:BM25 关键词检索 + 向量语义检索,用 RRF(倒数排名融合)合并结果,召回率提升显著
重排序(Rerank):用 Cross-Encoder 对检索结果二次排序,提升 Top-1 准确率
相似度阈值:设置 0.7-0.85 的阈值,低于阈值时触发拒答机制,避免胡编乱造
2. Prompt 工程优化
python
编辑
1prompt_template = """
2你是一个专业的技术支持助手。请严格基于以下文档内容回答问题,不要编造信息。
3如果文档中没有相关信息,请明确告知用户"未找到相关答案"。
4
5文档内容:
6{context}
7
8问题:{query}
9
10回答:
11"""
3. 性能优化
缓存高频查询:用 Redis 缓存热门问题的答案,减少重复推理
GPU 加速:本地部署时使用 vLLM 或 Ollama 框架,batch_size 设为 32 提升 GPU 利用率
增量更新:知识库变更时只重新向量化新增文档,避免全量重建
4. 多轮对话支持
python
编辑
1from langchain.memory import ConversationBufferMemory
2from langchain.chains import ConversationalRetrievalChain
3
4memory = ConversationBufferMemory(memory_key="chat_history", return_messages=True)
5conv_chain = ConversationalRetrievalChain.from_llm(
6 llm=llm,
7 retriever=vectorstore.as_retriever(),
8 memory=memory
9)
六、 学习路线建议
表格
下载为表格
导出为图片
阶段学习内容推荐资源
入门理解 RAG 原理、LangChain 基础组件LangChain 官方文档、Udacity OpenAI 课程
进阶混合检索、Rerank 重排序、Prompt 优化LlamaIndex 文档、RAGFlow 开源项目
工程化Docker 部署、监控告警、A/B 测试、用户反馈闭环FastAPI + Docker Compose + Prometheus
高阶知识图谱融合、多模态问答、Agent 工具调用Neo4j + LangChain Agents
- 上一页:Docker安装路线图完全指南:运维工程师必备手册
- 下一页:没有了
-
 问答系统入门教程:专业团队一站式搞定
这是一份 2026 年版问答系统(QA System)入门教程,结合你之前的 Docker 和后端开发背景,我按「原理 → 架构 → 技术选型 → 实战搭建 → 优化」的逻辑来展开,重点聚焦当前主流的 RAG(检索增强生成)架构。一、 什么是问答系统?问答系统(Question Answering System)是一种能理...
-
 商城开发多少钱案例展示:看看别人怎么做的
商城开发的费用跨度非常大,从几千元到上百万元不等。这主要取决于你的开发模式、功能复杂度以及技术架构。根据2026年的行业最新行情,我为你梳理了以下几种主流方案的费用区间及适用场景:一、 主流开发模式与费用区间1. SaaS平台/模板搭建(低成本、上线快...
-
 【收藏】SSD速成必备清单和注意事项
SSD 的核心知识其实可以压缩到五个维度里掌握:介质、接口、协议、颗粒、主控。把这五个点搞清,你就能看懂任何一块 SSD 的参数表并做出正确选购。一张图看懂 SSD 本质SSD 可以理解为“容量超大、速度极快的内置 U 盘”。它没有任何机械结构,核心由三部分组成...
-
 BI全攻略:从需求到上线一步到位
商业智能(BI)的核心,是将企业内外部海量、杂乱的数据,转化为驱动业务决策的“洞察”。结合你平时对软件开发、前沿科技以及品牌营销的关注,以下为你梳理了 BI 的核心逻辑、技术演进以及在商业运营中的落地价值:核心逻辑:从“数据”到“决策”BI 并不是...
-
 【瓦罗兰】虚拟主机学习笔记指南,帮你省时省钱
文库中暂时没有收录虚拟主机相关的文档资源,但通过网页搜索为你整理了一份系统的学习笔记,涵盖概念辨析和Web服务器虚拟主机配置两大核心板块。什么是虚拟主机?—— 两层含义"虚拟主机"这个词在不同语境下有两种含义,学习时需要区分:含义一:Web 服务器...
-
 数字化全攻略:从需求到上线一步到位
“数字化”是一个涵盖技术、业务和管理的宏大概念。简单来说,它是将信息转化为计算机可读的数字格式(0和1),并以此为基础重构业务流程、驱动业务创新的过程。为了让你更全面地理解,我们可以从核心定义、演进逻辑、以及实际应用三个维度来拆解:什么是数...