为什么你的富文本摘要面试题总做不好?问题出在这里
富文本编辑器的核心实现原理是什么?
富文本编辑器的核心基于浏览器提供的 contenteditable="true" 属性,使一个 DOM 元素(通常是

现代富文本编辑器(如 ProseMirror、Slate.js)不再直接操作 DOM,而是采用虚拟文档模型(如 ProseMirror Document / Slate Node Tree),将编辑操作抽象为事务(Transaction),通过命令模式(Command Pattern)来管理状态的变更、撤销和重做。
document.execCommand 是什么?为什么被废弃?
document.execCommand() 是浏览器提供的一组用于操作可编辑区域的命令 API,如 execCommand('bold')、execCommand('insertImage') 等。它曾是富文本编辑器的核心实现方式。
被废弃的原因:
各浏览器实现不一致,行为差异大,兼容性差
生成的 HTML 结构不可控,不同浏览器产生的标签不同
无法精细控制撤销/重做栈
已被 W3C 标记为过时,主流编辑器已转向自定义实现
富文本编辑器的数据模型有哪些?各有什么优劣?
表格
下载为表格
导出为图片
数据模型代表编辑器优点缺点
HTML 字符串wangEditor、UEditor直观、易于存储和渲染结构不可控、XSS 风险高
Delta/JSONQuill结构清晰、支持协同编辑需要额外的序列化/反序列化
虚拟 DOM 树ProseMirror、Slate.js精确控制、支持复杂操作学习曲线陡峭
Markdown ASTTiptap、Milkdown与 Markdown 互转方便对复杂富文本支持有限
实战类面试题
如何实现富文本编辑器的图片上传功能?
核心流程分为以下几步:
监听编辑器的 paste、drop 事件或工具栏的图片按钮
获取 File 对象后,先将其转为 Base64 进行本地预览(使用 FileReader)
同时将文件通过 FormData + XMLHttpRequest/fetch 上传到服务器
上传成功后,将服务器返回的图片 URL 替换掉 Base64 的 src
关键考点:
上传前需进行文件类型和大小校验
需要处理上传失败的回滚(移除预览图)
大图片建议先压缩再上传
需携带认证 Token(如 JWT)
富文本编辑器如何处理粘贴内容?
粘贴是富文本编辑器最复杂的场景之一,需要处理以下问题:
从 Word 粘贴:Word 会携带大量冗余的样式标签和 mso- 前缀的私有属性,需要通过正则或 DOM 遍历进行清洗
从网页粘贴:可能携带外部样式、脚本标签,需要过滤
纯文本粘贴:需将换行符转换为
或
标签
实现方式:监听 paste 事件 → e.preventDefault() 阻止默认行为 → 从 clipboardData 获取内容 → 清洗 HTML → 通过编辑器 API 插入干净内容。
如何实现撤销/重做(Undo/Redo)功能?
传统方式:依赖浏览器的 execCommand('undo') / execCommand('redo'),但不可控
现代方式:采用命令模式 + 历史栈。每次编辑操作封装为一个 Command 对象,压入历史栈。撤销时弹出栈顶命令并执行其 undo() 方法,重做时重新执行 redo()。ProseMirror 等框架内置了完善的事务历史管理机制。
富文本编辑器如何实现协同编辑?
协同编辑的核心算法有两种:
OT(Operational Transformation,操作转换):Google Docs 早期采用。核心思想是将用户的操作(如插入、删除)转换为可合并的原子操作,服务器负责协调多个客户端的操作顺序。
CRDT(Conflict-free Replicated Data Type,无冲突复制数据类型):Yjs、Automerge 等库采用。每个操作自带唯一标识和因果关系,客户端可以独立应用操作,最终达到一致性,无需中心化服务器协调。
安全类面试题
富文本编辑器如何防范 XSS 攻击?
富文本编辑器天然存在 XSS 风险,因为用户输入的内容会被渲染为 HTML。主要防护措施:
白名单过滤:只允许特定的 HTML 标签
-
 内容更新策略图文教程终极指南:少走弯路的秘诀
2026内容更新策略图文教程一、内容更新策略的底层逻辑内容更新策略并非简单的“定期发布”,而是围绕“用户价值、平台算法、内容生态”三大核心,构建可持续的内容生产与分发体系。2026年,随着AI工具的普及和用户对内容质量要求的提升,内容更新策略需从“...
-
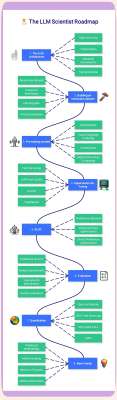 LLM优化避坑:这些错误你可能每天都在犯
大语言模型(LLM)的优化是一个系统性工程,通常需要从模型算法、推理引擎和应用架构三个主要维度入手。以下是当前主流的 LLM 优化方向与核心技术:一、 模型与算法层优化这一层的核心目标是在尽可能不损失模型精度的前提下,降低显存占用并提升计算效率。模...
-
 为什么你的全面SEO和GEO结合总做不好?问题出在这里
️ 第一步:夯实 SEO 地基(技术基建)GEO 并非空中楼阁,它高度依赖坚实的技术 SEO 基础。如果 AI 爬虫无法顺利抓取你的网站,GEO 就无从谈起。基础性能优化:确保网站加载速度快、移动端完美适配(Mobile-First)、URL 结构清晰,并配置好 Sitemap 和 Robots.txt(注意不要屏蔽 ...
-
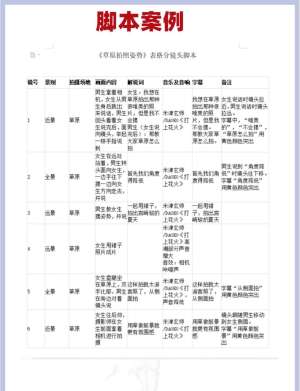 SEO脚本必备工具箱:免费又好用
在 SEO 脚本的选型上,我们不仅要关注收录效率,更要从软件开发和工程化的视角,看重其安全性、可维护性以及与现代 Web 架构的兼容性。目前主流的 SEO 脚本主要分为加速搜索引擎收录和优化页面渲染与URL结构两大类。以下为你梳理了目前最实用的技术方案:1. 加...
-
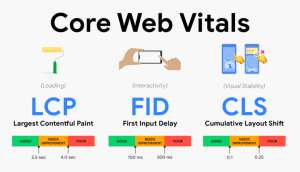 2026年系统Core Web Vitals的趋势、策略与工具大全
Core Web Vitals(核心网页指标,简称 CWV)是 Google 提出的一组用于衡量网页真实用户体验的关键性能指标。它直接反映了页面在加载速度、交互响应和视觉稳定性这三个维度的表现,并且已经成为 Google 搜索排名算法(页面体验更新)的重要考量因素。结合最新的搜索生态,...
-
 学Google算法案例之前必须知道的基础概念
Google 的算法更新非常频繁,其核心逻辑已经从早期的“关键词匹配”进化到了如今的“语义理解”和“真实价值评估”。结合最新的算法动态,为你梳理了以下几个极具代表性的实战案例,涵盖了医疗、电商、内容创作等不同领域:案例一:医疗电商网站(信任度与...